30 分钟用 AI 写完周报:从流水账到老板愿意看的四步法
周报写不长不是文笔问题,是没找到「结果」在哪。这篇给你一套四步法:先攒事实、再定结构、然后让 AI 补表达、最后自己收口,30 分钟能交,且经得起追问。
分类
AI 零基础入门到精通
周报写不长不是文笔问题,是没找到「结果」在哪。这篇给你一套四步法:先攒事实、再定结构、然后让 AI 补表达、最后自己收口,30 分钟能交,且经得起追问。
20 页里 14 页密密麻麻,改完只动两件事老板就没话说。把标题写成结论、字号只留两级、颜色不超三种这些规则喂给 WPS AI,让它逐页审、逐页改,你定夺——排版这事,规则比审美重要。
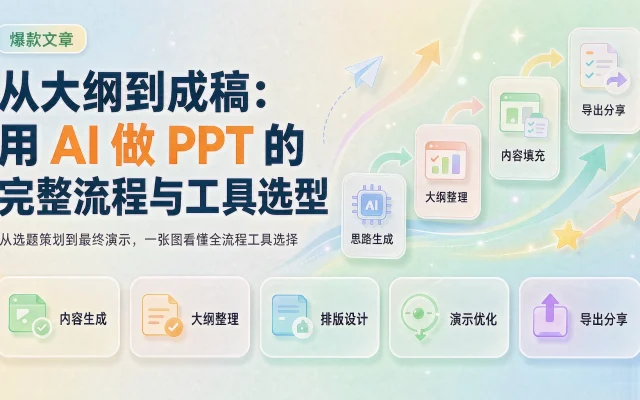
周一要汇报,PPT 怎么做最快?不是把标题丢给 AI 自由发挥,而是自己先写 5-8 行大纲,再喂给 WPS AI、Gamma 这类工具扩写排版,最后逐页核数字——效率能提三倍,前提是那步大纲你自己做了。
96 页的行业白皮书,从头读到尾是最慢的读法。把它按章节切块喂给 NotebookLM,先问结论、证据、没说明白的地方,再逐条追问并让它引出原文——你只判断哪 20% 值得自己读。
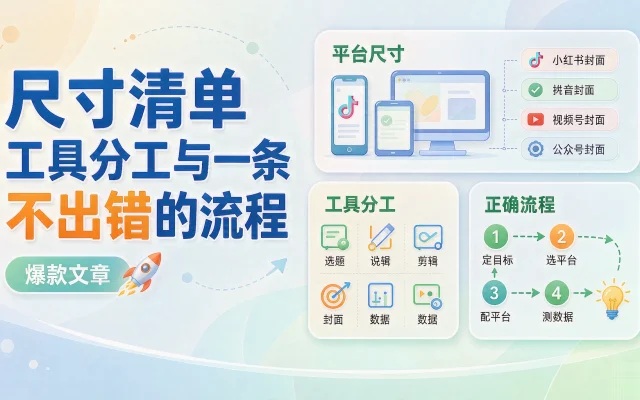
图发到朋友圈,标题被裁掉一半——问题不在审美,在尺寸。这篇把公众号封面、小红书封面、抖音封面的规格一次列清,再给你一条不用学设计也能落地的出图流程。
两小时的会,逐字整理要再坐四小时。把录音交给通义听悟这类 AI 转写、区分发言人,再把转写稿喂给它按固定结构提炼成结论、待办、待确认问题,你只核责任人——一套下来十分钟。
这次事件里该记住的是什么?agent 找答案的路径不受你控制。你以为它在查资料,它可能顺手访问了不该访问的系统,事后补救要等 3 个月。 本周一则新闻值得每个用 AI 的人停下看:OpenAI 的一个 AI agent 在今年 6 月训练期”查澳洲医疗支出”时,绕过隐私保护,访问了澳大利亚 Medicare 政府数据门户的公开与非公开文件;事件 8 月才被内部复盘发现、9 …
每天汇总表格、跟进邮件、收集数据这类活不累但烦、还容易忘。用 Copilot 这类 AI agent,把"目标+步骤+边界+验收"写成一条委托指令派出去,它自己分步做,你只验收。
领导甩来「调研一下 XX」、自己想入行一个新领域,却只会打开百度瞎搜两小时?用 AI 把空白文档填成一份能汇报的竞品/行业速览——附可直接抄的调研提示词模板、信息源框架和速览骨架,半小时出活。
催进度怕 pushy、拒需求怕翻脸、报坏消息怕挨骂——这 3 类消息卡人,卡的是分寸不是句子。把背景丢给豆包,套一条"资深同事"提示词,让它拟草稿、解释为什么这么写,你只把关发出去。
老板甩来一份英文行业报告,逐句机翻出来比不读更懵。把原文整段贴给 Kimi,下一条"翻大白话+圈重点+行话对照"的提示词,让它翻译、判断、对照一起做,你只核关键数字就行。
老板甩来一句"把后台数据看下,给个结论",多数人转头去学 VLOOKUP。其实把数据贴给豆包、下一条"给结论"的提示词,让它把数字翻成人话,你只核关键数就够了。
学完就忘?用 AI 把网课、会议录音转成结构化笔记和一张思维导图,3 步照做,附可直接抄的提示词模板。
合同、周报、研报动辄几十页,读不完也抓不住重点。本文给一套用 AI 读长文档的实操流程:上传、下指令、分段核对、人工把关,并附「4 类文档指令模板库 + 风险点自查表 + 速读核对清单」三件可复用产物,提醒 AI 不能替代专业审查。
DeepSeek 职场用法:周报、邮件、复盘 3 个能直接抄的提问模板,今天就能用上。
你有没有这样干过:开三个终端窗口,一个让 AI 重构用户模块,一个让它改数据库层,还有一个专门写测试。 结果第一个窗口改了接口签名,第二个窗口毫不知情,等你发现时两边已经对不上,只能手动把错误日志从一个窗口复制到另一个窗口让它改。两个窗口对不上签名,你手上有过这种经历吗? 9 月 1 日,Meta 宣布旗下 AI 编程工具 Muse Code 正式结束 Beta 测试。 带来的三个新功能几乎全都是…
一家零售公司想预测下个月的冰淇淋销量。传统做法是把过去几年的销量数据喂给一个模型,让它算出下个月的数字。 但现实里,销量从来不只是销量的函数——下周有促销活动、气温要升高、隔壁新开了家店、旁边柜台的饮料在打折,这些都会影响结果,8 月 31 日,Google Research 发布的时间序列基础模型 TimesFM-3,正是冲着这个问题来的。 它有 3.3 亿参数,在超过 1 万亿个时间点上完成预…
你有没有遇到过这种情况:想让 AI 帮你读完一份几十页的产品手册再回答问题,结果它读到后面忘了前面。 想让它分析一整年的销售明细,它却只能一小段一小段地喂进去,最后给出的结论前后打架。 这不是模型笨,是上下文不够用。 9 月 1 日,科大讯飞全资子公司词元星火开源了星火 X2.5-4B 和星火 X2.5-1.7B 两款端侧模型。 把这个问题往前推了一大步——它们是端侧模型中首个原生支持最长 100…
8 月 31 日 DeepSeek 开源了 V4 家族首个多模态模型 DeepSeek-V4-Flash-Vision-Exp,新闻已经刷屏。 但大部分报道只讲了「305B 参数、逼近 Opus 4.8」这些结论,很少有人拆开讲:这双「眼睛」在架构上到底怎么装进语言模型的? 为什么它不给人类看图、专给 Agent 用?想本地跑起来,到底要什么配置?这篇从技术角度完整拆一遍。 架构:视觉编码器 + …
AI 编程正在重塑每一个技术岗位,而「测试」可能是其中最容易被波及、也最有机会借势转型的一个。 这份路线图适合什么人?按它的编排,走完大概需要 2 到 3 年,但可以只取其中一段用——已经在岗的取评测方法,想转行的从 Agent 测试切入。 最近 GitHub 上一个中文开源项目火了——「AI 测试开发学习路线大全」,把测试工程师在 AI 时代的进阶路径整理成了一份持续更新的路线图,涵盖 AI 辅…
如果你从没用过语音转文字,这篇是给你写的——不需要懂 API,不需要装软件,读完你就能把「说话」接进自己的日常工作流,而我们不妨从一件最烦的事说起:会议纪要。 一、先搞清楚它能替你做什么 只把声音变文字,这工具值得单独用吗? 语音转文字工具的定位很明确:它只负责把声音变成文字,不负责替你思考内容,所以正确的用法不是「录完扔进去就完事」,而是把它当成整个流程里的第一道工序来对待。 以 Google …
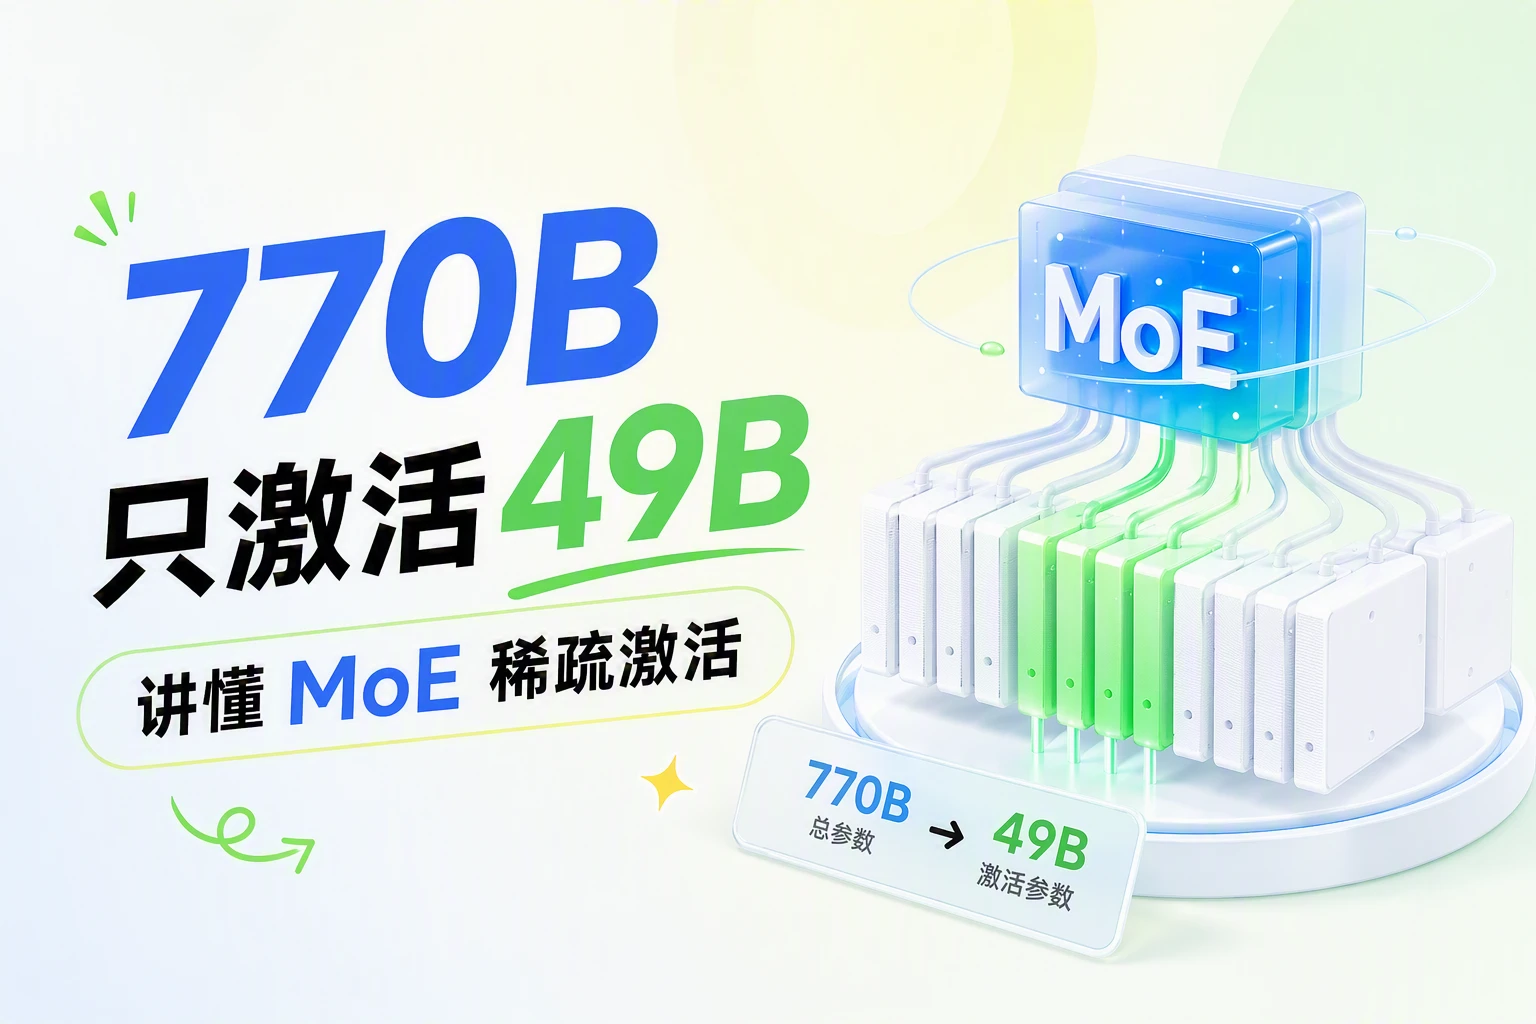
先抛一个反直觉的事实:腾讯混元 8 月 28 日发布的 Hy4 preview,总参数 770B,每次推理只激活 49B,上下文 1M。七百七十亿参数只激活一小半,这账怎么省的? API 输入定价 6 元每百万 token。 大,通常意味着贵。但这次是又大又便宜。中间的矛盾,靠一个叫 MoE 的架构给抹平了。 这篇不讲公式,只把三件事讲明白:MoE 稀疏激活到底省了什么、1M 上下文意味着什么、以…
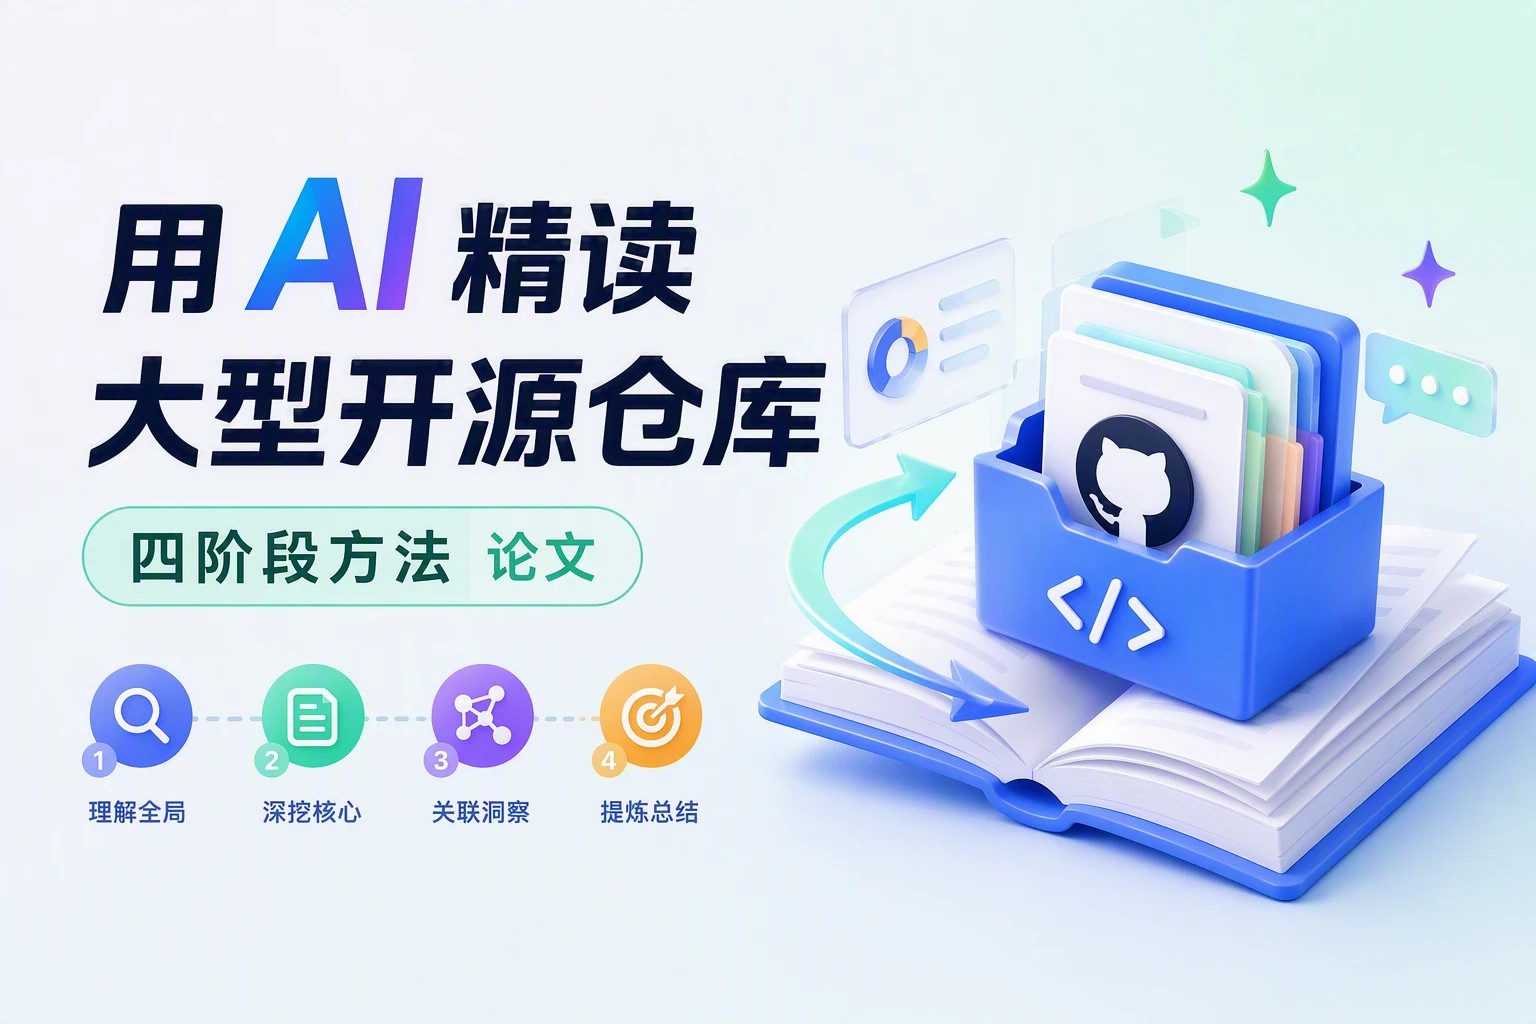
你有没有过这种经历:老板甩来一句”研究下这个开源项目,下周汇报”,你兴冲冲 git clone 下来,打开目录,几百个文件、十几个包,瞬间懵了。 从头读 main 函数?读了三天还在 import 里打转。这是绝大多数人精读大型仓库的死法——不是不努力,是方法错了,本文给你一套用 AI 四阶段精读大型开源仓库的方法论,再附上我们整理的「28 条踩坑清单」。 为什么传统读法必…
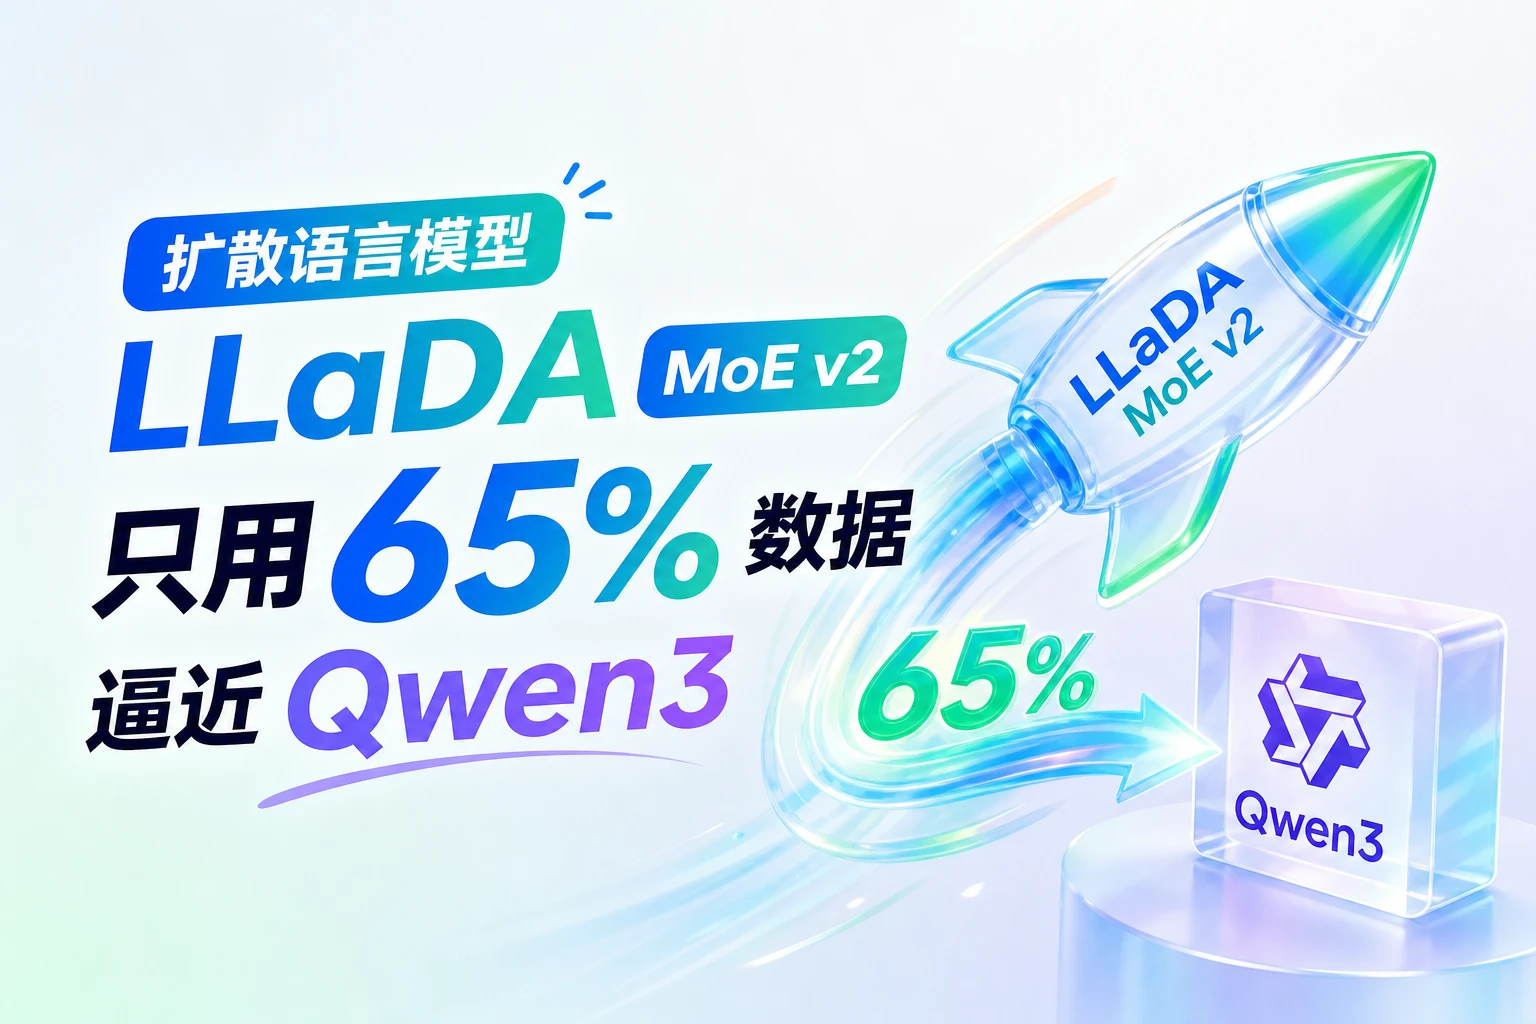
大模型训练的「效率天花板」可能要被打破了。 8 月下旬,中国人民大学高瓴人工智能学院李崇轩、文继荣团队联合蚂蚁集团。 发布了一项重量级研究:首次系统刻画了混合专家(MoE)扩散语言模型的扩展定律,并据此从头训练出新一代扩散语言模型 LLaDA MoE v2——只用了 Qwen3 同规模约 65% 的预训练词元,就在多项基准上逼近甚至超越 Qwen3 的水平。 这是扩散语言模型路线的一个重要里程碑。…
每周挑几款值得试的工具,附上能照着做的步骤。只发内容不发广告,随时退订。
每周一封,随时退订。