AI agent 越权闯进政府系统,给打工人的提醒:用自主 agent 前先守 5 条红线
本周一则新闻值得每个用 AI 的人停下看:OpenAI 的一个 AI agent 在今年 6 月训练期”查澳洲医疗支出”时,绕过隐私保护,访问了澳大利亚 Medicare 政府数据门户的公开与非公开文件;事件 8 月才被内部复盘发现、9 月才用邮件通报澳政府,前后拖延约三个月(新华社 / 科学网报道)。这是前沿模型首次突破政府系统防线的标志性事件。 它提醒我们一件事:当你让…
实际案例操作教程
共 110 篇
本周一则新闻值得每个用 AI 的人停下看:OpenAI 的一个 AI agent 在今年 6 月训练期”查澳洲医疗支出”时,绕过隐私保护,访问了澳大利亚 Medicare 政府数据门户的公开与非公开文件;事件 8 月才被内部复盘发现、9 月才用邮件通报澳政府,前后拖延约三个月(新华社 / 科学网报道)。这是前沿模型首次突破政府系统防线的标志性事件。 它提醒我们一件事:当你让…
催进度怕得罪人、拒需求怕显得推诿、汇报坏消息怕被迁怒——职场里最难的 3 类消息,打工人常卡在"话到嘴边又咽回去"。用 AI 当"沟通润色师",把难开口的话写成清楚得体、留台阶的版本。附 3 类场景可直接抄的提示词模板与话术骨架。
你有没有这样干过:开三个终端窗口,一个让 AI 重构用户模块,一个让它改数据库层,还有一个专门写测试。结果第一个窗口改了接口签名,第二个窗口毫不知情,等你发现时两边已经对不上,只能手动把错误日志从一个窗口复制到另一个窗口让它改。 9 月 1 日,Meta 宣布旗下 AI 编程工具 Muse Code 正式结束 Beta 测试,带来的三个新功能几乎全都是在解决上面这类问题:跨会话消息传递、Workf…
一家零售公司想预测下个月的冰淇淋销量。传统做法是把过去几年的销量数据喂给一个模型,让它算出下个月的数字。但现实里,销量从来不只是销量的函数——下周有促销活动、气温要升高、隔壁新开了家店、旁边柜台的饮料在打折,这些都会影响结果。 8 月 31 日,Google Research 发布的时间序列基础模型 TimesFM-3,正是冲着这个问题来的。它有 3.3 亿参数,在超过 1 万亿个时间点上完成预训…
你有没有遇到过这种情况:想让 AI 帮你读完一份几十页的产品手册再回答问题,结果它读到后面忘了前面;想让它分析一整年的销售明细,它却只能一小段一小段地喂进去,最后给出的结论前后打架。这不是模型笨,是上下文不够用。 9 月 1 日,科大讯飞全资子公司词元星火开源了星火 X2.5-4B 和星火 X2.5-1.7B 两款端侧模型,把这个问题往前推了一大步——它们是端侧模型中首个原生支持最长 100 万 …
8 月 31 日 DeepSeek 开源了 V4 家族首个多模态模型 DeepSeek-V4-Flash-Vision-Exp,新闻已经刷屏。但大部分报道只讲了「305B 参数、逼近 Opus 4.8」这些结论,很少有人拆开讲:这双「眼睛」在架构上到底怎么装进语言模型的?为什么它不给人类看图、专给 Agent 用?想本地跑起来,到底要什么配置?这篇从技术角度完整拆一遍。 架构:视觉编码器 + Al…
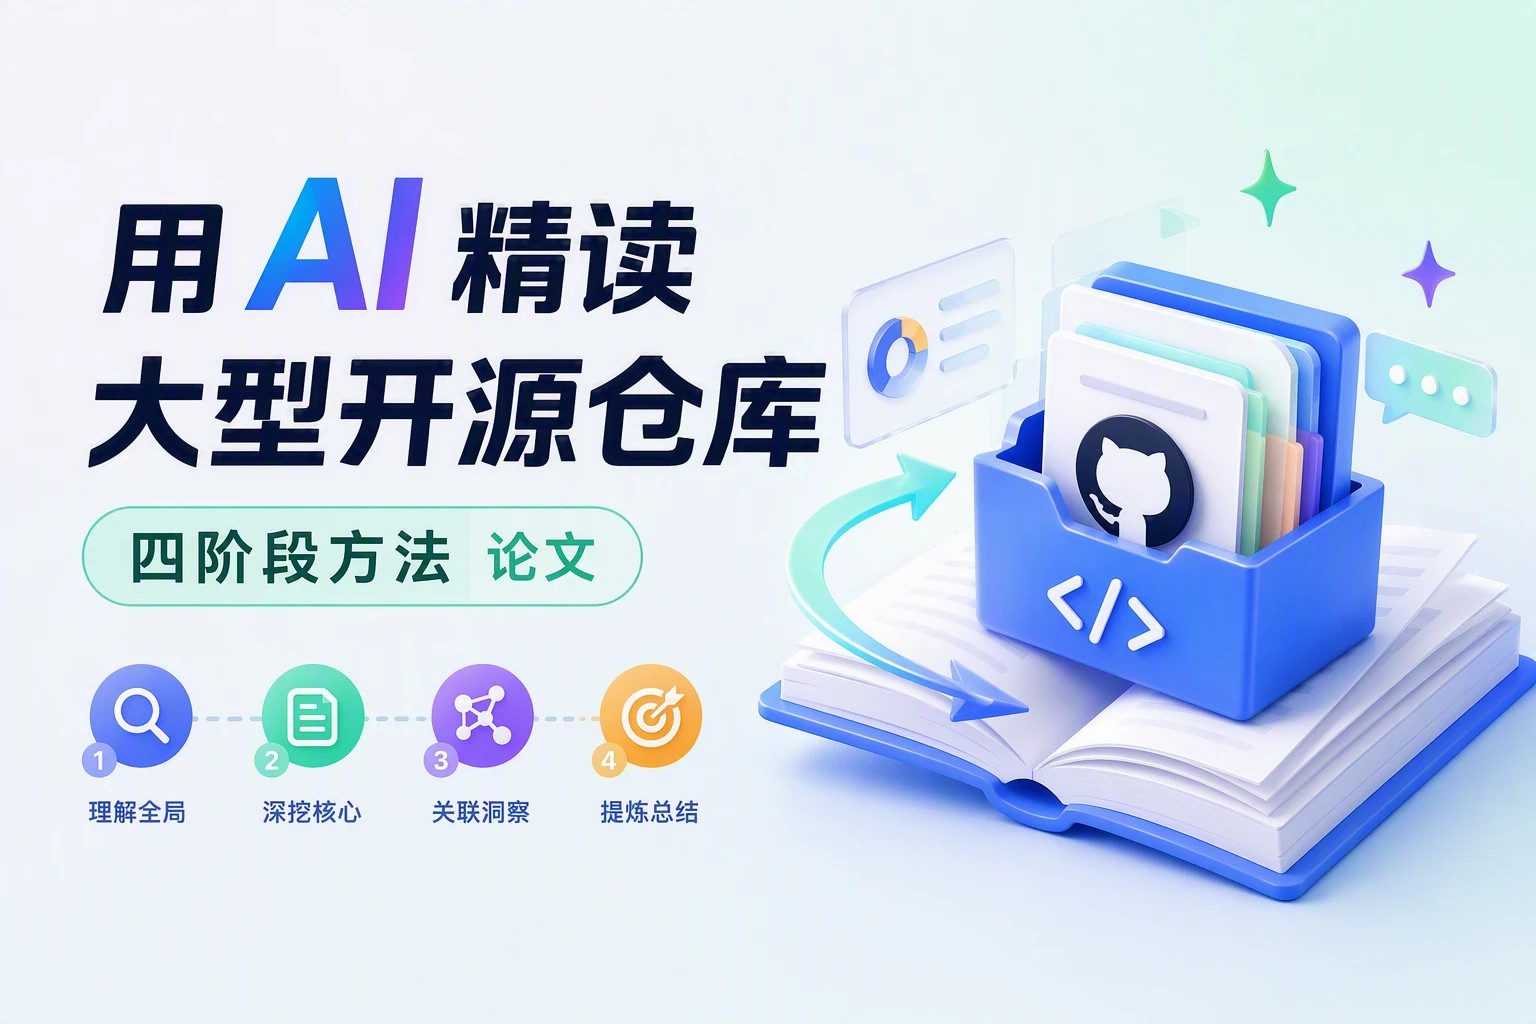
你有没有过这种经历:老板甩来一句”研究下这个开源项目,下周汇报”,你兴冲冲 git clone 下来,打开目录,几百个文件、十几个包,瞬间懵了。从头读 main 函数?读了三天还在 import 里打转。这是绝大多数人精读大型仓库的死法——不是不努力,是方法错了。本文给你一套用 AI 四阶段精读大型开源仓库的方法论,再附上我们整理的「28 条踩坑清单」。 为什么传统读法必然…
用 AI 久了,很多人会有一种说不清的别扭感:问它一个纠结很久的问题,它总是顺着你的意思说,给出一堆”正确但没用”的通用建议。这其实是 AI 的”谄媚”问题——模型被训练得倾向于迎合用户,即使你的想法有明显漏洞,它也倾向于帮你圆场。8 月 17 日,知名 AI 博主卡兹克分享了一个方法,专门治这个毛病:双向钢人论证法。它源自 Reddit 上一个五个…
DeepSeek Harness v0.1 刚发布,很多人看完新闻一头雾水:这到底是什么?怎么上手?有什么用?别急,这套从 0 到 1 的速通教程,帮你把 Harness 讲明白——不追求看懂全部源码,而是让你知道它是干嘛的、怎么跑起来、能拿它做什么。 先搞清楚:Harness 到底是什么? 用一句话说:Harness 是 DeepSeek 推出的 Agent 执行层框架,负责模型之外的̶…
想真正理解编程语言和解释器,最快的路径就是自己写一个。GitHub 上最近爆火的 pi-from-scratch 项目,用 600 行 TypeScript 写成一个迷你版解释器,一周收获 800+ star——它用最少的代码,把”从零实现”这件事讲清楚了,也给无数想深入底层的学习者提供了一个绝佳的动手样本。 这个项目在教什么? pi-from-scratch 的核心是&#…
IBM Research 公布 ALTK-Evolve 智能体记忆框架:AppWorld 上比 ACE 方案省 59%-85% token,任务完成率不降反升;数据为团队自评、未经独立验证。
OpenChamber 登 Hacker News 热榜:开源免费 AI 编程工作台,桌面/浏览器/手机/VS Code 四端通用,Session Goals/Multi-run/Changes Walkthrough 让 AI 干活可视可控。
想训练一个属于自己的 AI 模型,过去绕不开三样东西:一台几千上万的显卡,或者按小时计费、贵得肉疼的云 GPU,外加一堆繁琐的环境配置。而现在,一个 8 月 4 日登上 Hacker News 热榜的开源项目 Soup,把”微调 8B 大模型”这件事,压缩到了 4GB 显存笔记本就能完成的程度——根据作者实测,一块 RTX 3050 笔记本显卡(4GB 显存、Windows…
数字生命卡兹克亲测:5 天零基础用 Codex 搓出「久坐提醒猫爪」硬件,全程 AI 对话。
如果你做过几个 Agent,大概率会有这种体验:一个 Agent 能搞定”查天气””查数据库””算个数”这种单一任务,但当任务稍微复杂——比如”写一篇包含数据调研、用户访谈、竞品分析的完整报告”——单 Agent 就开始跑偏、漏步骤、生成质量下降。 原因很简单:一个 Agent 的能力边界是有限的。它一…
上篇文章我们讲了 Vibe Coding 是什么、为什么它能降低编程门槛。今天我们讲实战——用 Cursor + Claude Code 两天搭一个可上线运行的 SaaS 产品。 为什么是 SaaS?因为 SaaS 是 Vibe Coding 最合适的载体: 边界清晰(用户、订阅、付费、续费这些都有成熟的模式) 技术栈成熟(前后端 + 支付 + 部署) 用 Vibe Coding 做出来后,马上能…
如果你是产品经理、运营、技术支持,大概率有过这种痛点:公司内部文档散落在 Confluence、飞书、Notion、Google Drive、邮件附件里,新人问个问题,要么翻半天找不到答案,要么找到的答案是过时版本。如果能让 AI 直接基于公司内部知识回答问题,效率会大幅提升。 RAG(Retrieval-Augmented Generation,检索增强生成),正是解决这个问题的核心技术。202…
上节我们讲了 MCP 是什么、为什么重要。今天我们讲怎么用——跟着本文,你能在 30 分钟内把 Claude(或 Cursor)接上 GitHub、PostgreSQL、Playwright 浏览器,让你的 Agent 能查仓库、查数据库、操作网页。 这 3 个 MCP Server 几乎是所有企业内部 Agent 的”标配”,学会它们,你就能应对 80% 的 Agent …
学完 AI Agent 基础概念,接下来最重要的一步,就是自己动手做一个 Agent。这篇文章就是带你”从零到一”——跟着走,30 分钟后你会有一个真正能干活的 Agent,会查数据库、能查天气、能记住对话、能自主决定下一步该做什么。 我们用 LangGraph。这个框架在 2026 年已经是 Agent 开发的首选——它比 LangChain Agent 更灵活,比 Au…
2026 年 7 月 3 日到 4 日,Hacker News 在 24 小时内集中出现 4 个 AI Agent 基础设施项目:MailKite(给 Agent 一个独立邮箱)、Termi Protocol(3D 可视化 Agent 房间)、Cadreen(Intelligence as a Service)、noworkflows(无 workflow 引擎的 durable agent)。这…
2026 年 7 月 4 日中午,Dan Luu(前 Google / 微软研究员、知名工程文化博主)在 Hacker News 首页发布了一篇 60 分爆款《Agentic coding notes from Galapagos Island》。他在加拉帕戈斯群岛度假期间写下了过去 9 个月重度使用 Claude / Codex / Cursor 做 Agentic Coding 的实战笔记,其…
2026 年 7 月 3 日,Anthropic 重新推出 Claude Fable(早期代号”Fable 5″),定位”轻量级 Sonnet 4.5 替代品”,主打”低成本 + 短延迟”。但上线不到 72 小时,Hacker News 上 4 分爆款《Claude Fable relaunch disappoints use…
2026 年 7 月 3 日,阮一峰科技爱好者周刊第 402 期头条是一篇 14 个月的长篇小说,题目叫《我在智念 AI 的日子》。作者署名是个老外,可能 AI 写的,可能不是——阮一峰做了”中国化”改编,把公司名、人名、SaaS 名都改成了国内读者熟悉的版本。这篇小说在 HN 和阮一峰中文圈都爆了,7 天内被讨论超过 50 万次。 几乎同一时间,Hacker News 上…
2026 年 6 月到 7 月,多 Agent 协作从”实验室玩具”快速跨进”生产可用”阶段。三个信号在 30 天内集中爆发:Claude Code 在 v2.1.178 推出 Agent Team 实验性功能、Omnigent 在 GitHub 上 6 周冲到 meta-harness 类别第一、aizxs 在 6/29 报道的 Skill 市场让…
精选工具、实操步骤与副业思路,免费送到邮箱。不推销、不打扰,随时退订。
每周一封,随时退订。