你有没有过这种经历:老板甩来一句”研究下这个开源项目,下周汇报”,你兴冲冲 git clone 下来,打开目录,几百个文件、十几个包,瞬间懵了。
从头读 main 函数?读了三天还在 import 里打转。这是绝大多数人精读大型仓库的死法——不是不努力,是方法错了,本文给你一套用 AI 四阶段精读大型开源仓库的方法论,再附上我们整理的「28 条踩坑清单」。
为什么传统读法必然失败
一上来就读实现代码,等于没地图就钻下水道。可绝大多数人偏偏这么读,读到第三天就放弃了。卡住你的到底是代码,还是顺序?
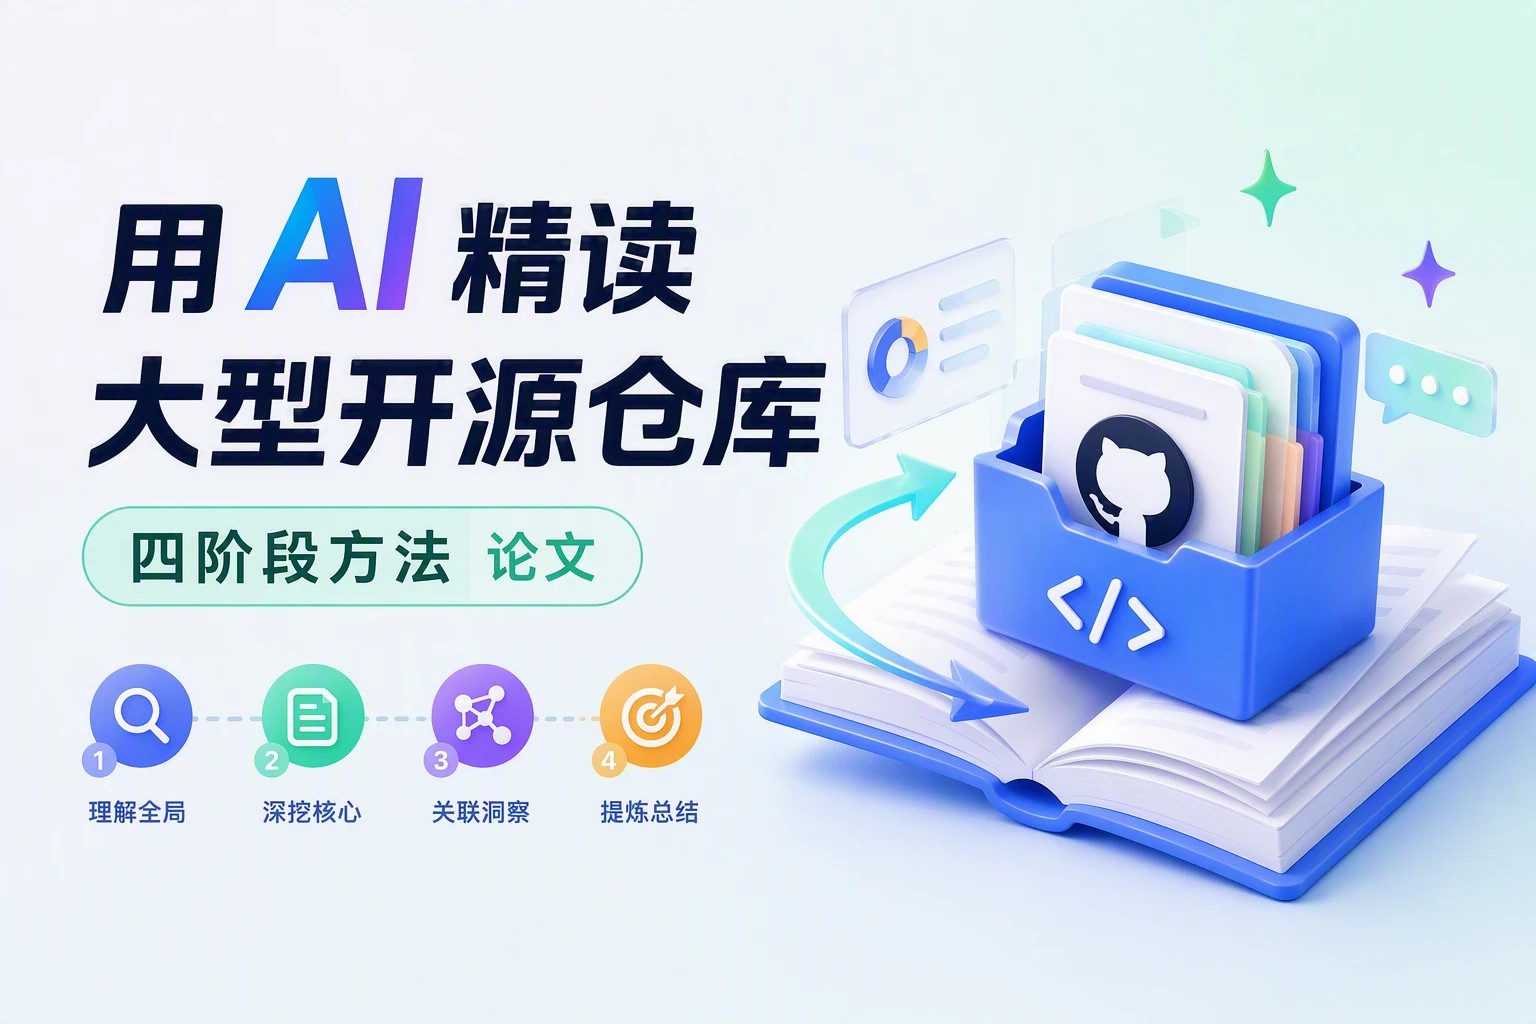
大型开源仓库不是一本书,它有历史、有演进、有取舍,代码只是它”此刻的样子”,如果你一上来就读实现代码,等于在没有地图的情况下钻进一座城市的下水道,正确顺序是:先建立全局结构感,再下钻关键路径,然后动手验证,最后用输出倒逼真懂。
下面四阶段就是这条路径。
阶段一:浏览结构(别一上来读代码)
把仓库当一座城市,先要一张地图。
让 AI 帮你做两件事:画目录地图和梳理模块关系,把整个仓库结构贴给 AI,让它输出”哪个目录负责什么、模块之间怎么依赖、数据从哪进从哪出”,这一步的目标是建立”上帝视角”,知道每个零件大致在哪个抽屉,而不是立刻拆开看齿轮。
提示:让 AI 输出一张”模块职责表”——左列目录、右列它负责的事、再加一列它依赖谁。这张表会贯穿你后面所有阶段,比任何单篇文档都好用。
阶段二:读核心模块(挑 2-3 个最关键文件让 AI 逐段讲)
80% 的价值藏在 20% 的文件里。2 到 3 个文件该怎么挑?挑错了是不是等于白读一遍?
别贪多。
一个仓库里 80% 的价值藏在 20% 的文件里,结合阶段一的地图,挑出 2-3 个最核心的文件(通常是领域模型、核心调度、核心抽象),让 AI 逐段讲解:这段在干嘛、为什么这么写、边界在哪,关键不是”AI 讲完我听一遍”。
而是你随时打断追问——”这里为什么用递归不用循环””这个异常谁来处理”,对话式精读,比静读效率高一个数量级。
阶段三:跑起来验证(clone 真跑,AI 帮解读报错)
读懂不等于能跑起来。这一步要配环境、造输入、故意改坏看反应,光跑通一次够不够?
读懂不等于能用。真正吃透一个项目,必须把它跑起来。配环境、造最小输入、看输出,然后故意改一点看行为变化。
报错是最好的老师:把报错堆栈丢给 AI,让它解释”为什么崩、崩在哪一层、怎么改”。很多你读十遍代码都悟不到的设计约束,一次真实报错就讲明白了,这一步也是检验你前两个阶段理解是否正确的试金石。
阶段四:做输出(写笔记/教程才算真懂)
写不出笔记的部分,就是没真懂的部分。可教程到底写多细才算够?写给谁看,用什么标准衡量?
费曼学习法放这里最灵:你能不能把”这个仓库怎么工作的”写成一篇别人看得懂的笔记或教程?写不出来的部分,就是你没真懂的部分。
输出可以是内部 Wiki、一篇博客、一段给同事的讲解录音,甚至是给项目提的一个文档 PR。只有当你能教别人时,才算精读完成。
| 阶段 | 核心动作 | 常见错误 |
|---|---|---|
| 一·浏览结构 | 让 AI 画目录地图与模块关系 | 一上来扎进某个文件硬读 |
| 二·读核心 | 挑 2-3 文件让 AI 逐段讲、随时追问 | 试图从头到尾通读全部代码 |
| 三·跑验证 | clone 真跑,用报错反向学习 | 只停留在”看懂”,从不执行 |
| 四·做输出 | 写笔记/教程倒逼真懂 | 读完即忘,不做任何沉淀 |
28 条踩坑清单(先放 10 条代表条目)
28 条踩坑先放了最高频的 10 条。剩下 18 条要不要另开一篇?还是先自己走一遍四阶段?
下面是我们在带学员精读仓库时沉淀的「28 条踩坑清单」中,最高频的 10 条。这些都是血泪教训,不是某篇外部文章抄来的,而是实践里反复踩出来的:
1. 别信 README 过时描述。README 常落后于代码半年,以代码为准,README 只当入口。
2. 环境依赖先锁版本。先读 requirements/lockfile/Dockerfile,别直接 pip install 最新版,否则坑在兼容,3. 测试是最好的文档。看测试用例比看文档更快懂作者的真实意图与边界条件。
4. 别忽略 CHANGELOG。版本演进里藏着”为什么这么改”,是理解设计动机的捷径。
5. 先找核心抽象,别从入口硬啃。领域模型、核心接口往往比 main 更值得先读。
6. 别一个人闷头读。让 AI 当陪练逐段讲,效率远高于孤军奋战。
7. 跑起来比读懂更重要。真实报错揭示的设计约束,十遍静读也换不来。
8. 别忽略 CI 配置。.github/workflows 里藏着真实构建流程与质量门禁。
9. 警惕”看起来聪明的写法”。炫技代码往往是维护雷区,读懂意图即可,别盲目模仿。
10. 抄代码不写笔记 = 白读。
输出(笔记/教程/PR)才是真懂的证明,剩下的 18 条——包括”如何快速定位性能热点””怎么读没文档的遗留系统””多仓库 monorepo 怎么拆””如何用 git blame,追设计动机”等——是我们整理的完整「28 条踩坑清单」。
可在「AI智习室」主页获取,这套清单配合上面四阶段用,基本能覆盖从入门到能独立给项目提 PR 的全过程。
一条最省路的行动建议
今晚就挑一个你一直想懂但没敢碰的仓库,严格按四阶段走:先让 AI 出地图,再精读 2-3 个核心文件,接着 clone 跑一个最小例子,最后写一篇不超过 500 字的笔记,跑完一轮,你会发现”读源码”从劝退变成了可拆解的工程动作。
· · · · ·
📌 关注「AI智习室」,回复「28 条」获取完整精读踩坑清单。我们用可落地的方法,帮你把 AI 真正用成生产力。