「脚本我写得明明白白,怎么 AI 出来的片子全对不上?」上周五晚上,做零食带货号的小唐把手机推到我面前——屏幕里那条三十秒视频,画面里全是她要的东西,可产品特写插在口播中间,收尾镜头莫名其妙冲到了开头。
她不是没试过 AI。两三百字的脚本整段贴进去,工具也老老实实出了片,问题是字幕跟画面对不上,剪的时候比不用 AI 还费劲。
问题不在工具,在投喂方式:她把三十秒的脚本当成一句话丢给了 AI。
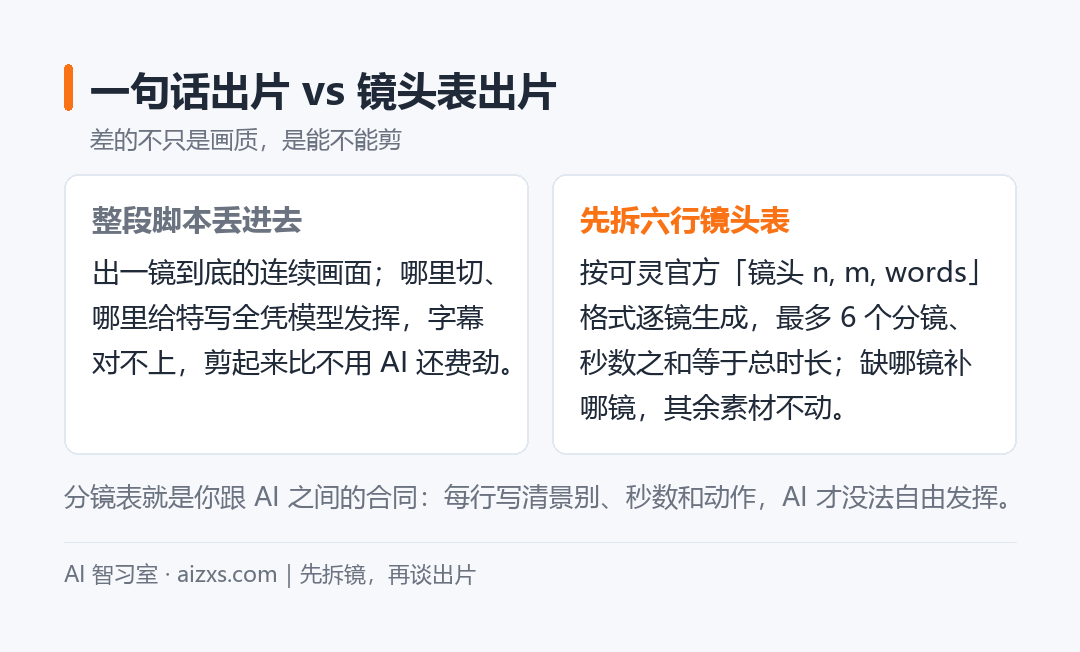
一句话出片,出来的是一镜到底的连续画面;能剪的片子,是一组按镜头切好的素材。中间差的那一步,叫分镜。
一句话出片,为什么拼不成一条片子
为什么整段脚本直接丢给 AI,回来的东西就是没法剪?
因为生成工具拿到一整段话,只会把它压成一个连续画面,哪里该切、哪里该给特写,全凭模型自己发挥。你在脚本里写「先给产品特写,再切全景,最后回到人物」,它看到的只是一段描述,不是一张镜头表。
做短视频真正要做的翻译,是把「讲什么」翻成「拍什么」:哪一秒是全景、哪一秒是特写、每镜几秒,拆得越清楚,AI 给的素材越好剪。
这一步官方其实已经给了标准答案。可灵官方 API 文档写明,可灵视频 3.0 支持用固定格式生成多镜头视频——「镜头 n, m, words」,n 是分镜序号,m 是这一镜的秒数,words 是这一镜的画面描述。
分镜序号最多支持 6 个,所有分镜的秒数加起来,必须等于视频总时长。
换句话说,官方推荐的用法本来就是拆成最多 6 个镜头、逐镜去喂,这跟剪辑师开工前先画分镜表,是同一套逻辑。
第一步:把脚本压成六行镜头表
拿小唐那条三十秒零食视频举例。脚本原本是一段两百字的口播词,拆完是这样的:
- 镜头一,3 秒,中景:深夜书桌前,女生拆开快递盒,台灯暖光
- 镜头二,4 秒,特写:手指掰开酥脆的零食,断面掉渣
- 镜头三,5 秒,近景:女生咬一口,眼睛睁大点头
- 镜头四,4 秒,特写:包装袋正面缓慢推近,logo 清晰
- 镜头五,6 秒,中景:女生举起产品对着镜头说话
- 镜头六,8 秒,特写转中景:产品摆在桌面,留出字幕位收尾
六行,每行三样东西:景别、秒数、画面里发生的事,3 加 4 加 5 加 4 加 6 加 8 正好三十秒。
写每一镜时只描述画面里发生什么,别写「突出卖点」「有感染力」这类要求。
即梦官方短剧页给的提示词示例就是这么写的:镜头先用中远景交代二人的位置,再贴近侧面跟随出剑动作,最后停在近距离僵持的一刻——景别、动作、停点,全是能执行的画面指令,没有一句形容词。
第二步:逐镜出画面,锁住人物
镜头表有了,接下来逐镜生成,有两条路可走。
省事的一条:把六行直接按可灵的官方格式拼成一段提示词,一次生成六个镜头,模型自己按秒数切。精修的一条:在可灵或即梦里逐镜出画面,用即梦官方短剧页说的办法——把角色图固定下来,每一镜沿用同一段人物描述,出完逐镜检查外观。
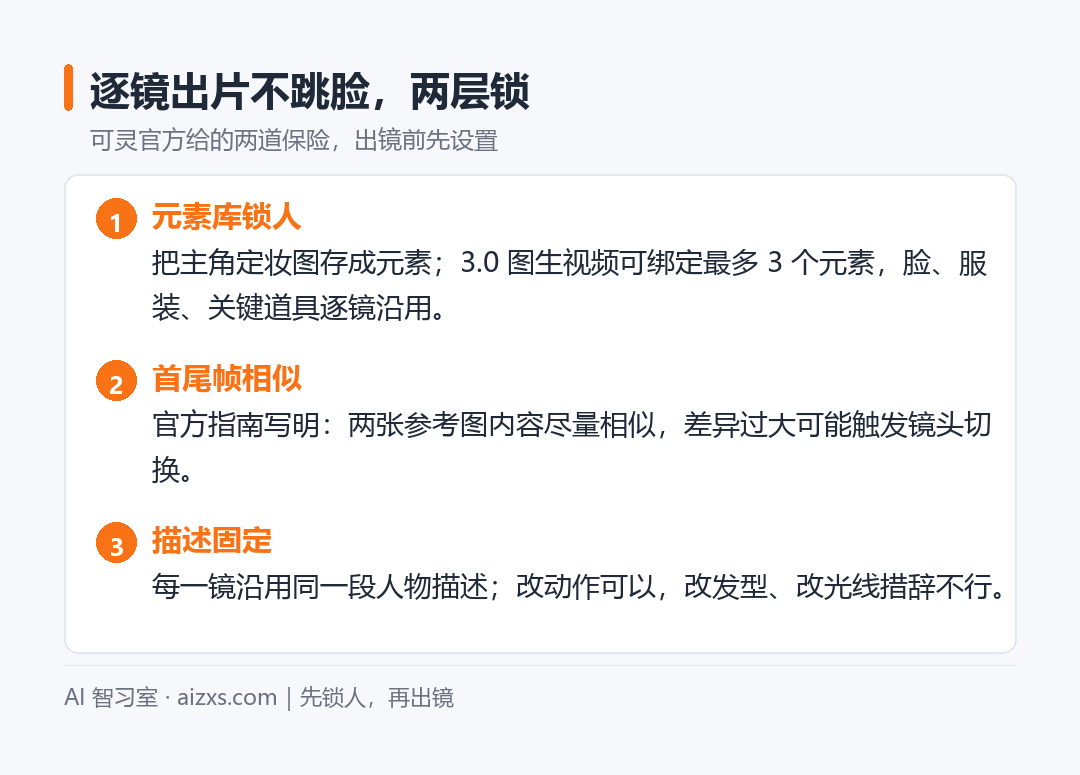
逐镜出片最大的坑,是镜与镜之间「换了个人」。
可灵官方给了两层解法:一是首尾帧功能,官方指南写明两张图的内容要尽量相似,差异过大可能触发镜头切换;二是 3.0 的元素库,图生视频时可以绑定最多 3 个元素,把主角的脸、服装、关键道具锁住,换镜头不换人。
小唐的实际操作,是把女主定妆图存成元素,六个镜头全部从元素库里点选同一个人。出完六段素材回看,发型、服装、脸没有一次跳。
第三步:对着镜头表验收,缺哪补哪
六段素材到手,先别急着拼。
为什么非要对着镜头表验收?
把镜头表摆在旁边一镜一镜对:景别对不对,秒数够不够,主角是不是同一个人。对着表验收有个好处——缺哪一镜清清楚楚,某一段动作不对就单独重出那一镜,其余五段不用动。
这件事直接关系到钱。上一轮我们对比过可灵和即梦的积分消耗账,积分按次扣,返工次数就是成本,整段重来和只补一镜,差出好几倍。
验收完拼回剪映,按镜头表顺序排轨道,配乐字幕压上去,一条三十秒的片子就算成了。
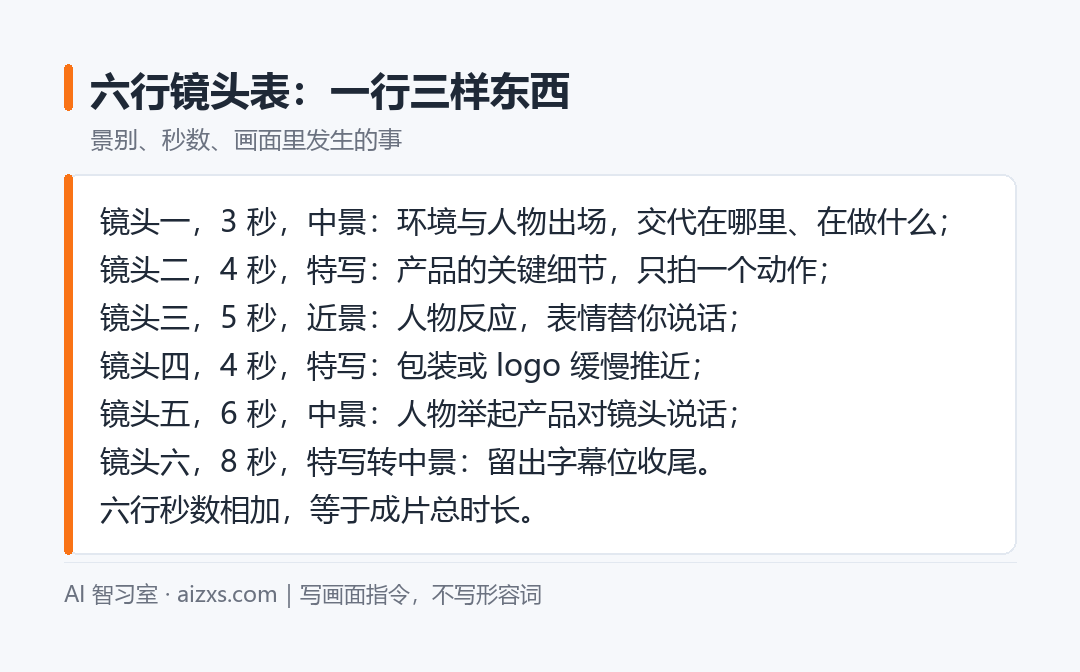
分镜表就是你跟 AI 之间的合同:每一行写清景别、秒数和动作,AI 才没法自由发挥。
收尾:先拆镜,再谈出片
回到开头小唐的问题。她后来把同一份脚本按这六行重跑了一遍,当晚就出了能剪的版本,第二天上午片子挂上号。
工具从一句话出片进化到多镜头生成,路已经铺好了,差的只是你肯不肯先花十分钟拆镜头。
你上一次让 AI 出视频,废在第几镜?评论区聊聊。