个人助手答偏那天,我陪他改了四个参数
下午四点十分,他敲了一句「出差住宿超标怎么审批」,助手回了三段话。
看着像那么回事。条款编号也编出来了。可公司那份《差旅管理办法》里根本没有这一条。
这是他换的第三个模型。前两个也一样,答得流畅,答得不对。
我把这一天的记录按时间顺序理了一遍。真正修好它,靠的不是换模型,是四个参数。
9:20,八十份文件倒进知识库
他做内训,手上八十多份材料:差旅管理办法、报销细则、培训 SOP、几十份岗位手册。
建库这一步,他花了八分钟。名字一填,文件一拖,解析方式没动,切片方式和分段长度也没动,直接点创建。
阿里云百炼这套流程里,这两个默认值分别是「智能切分」和「最大分段长度 600」,可调范围 10 到 6000 个字符。
600 字对一篇公众号文章够用。对一份条款型制度文件,偏小。为什么偏小?因为制度文件是按条写的,一条一句话说完,中间不该有断口。
库建完,状态显示已就绪。他以为活儿干完了。
10:40 翻车:答得准的问题,都落在同一段里
问「报销标准是多少」,答得准。问「住宿超标怎么审批」,开始编。
他当时的判断很自然:模型不行,换一个。十一点换了第二个,下午两点换了第三个,表现一模一样。
你猜他在这两个多小时里做了什么?填表、等额度、复制那八十份文件重新上传,三遍。
有个细节,下午才看清:答得准的那几个问题,答案都落在文件的同一段里;答偏的那几个,答案都跨在两段之间。
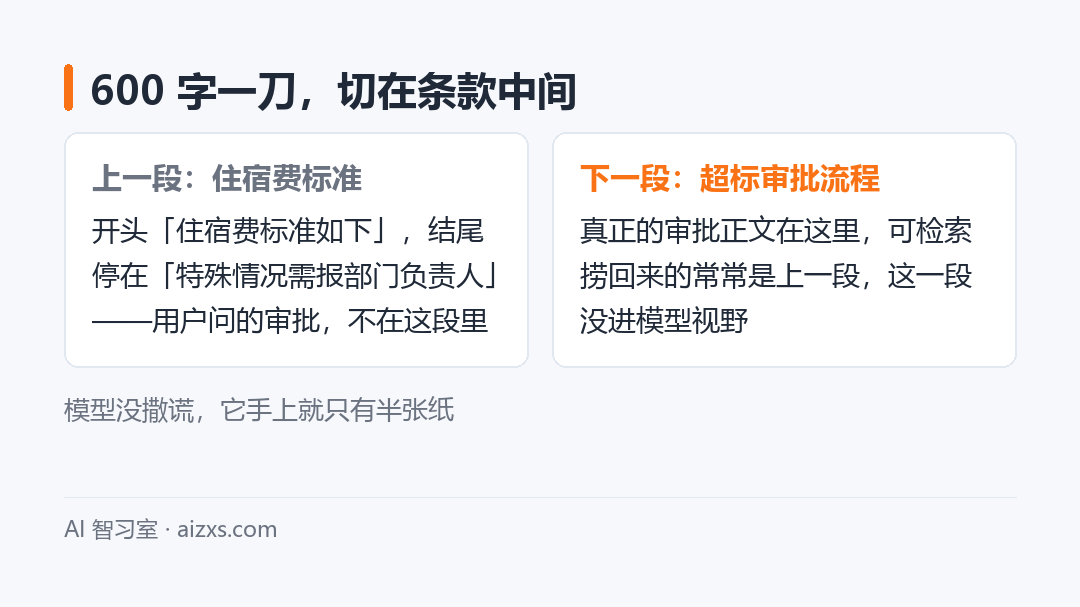
《差旅管理办法》的原文里,「住宿标准」和「超标审批流程」本来是连着写的两小节。600 字一刀下去,标准留在上一段,审批落到下一段。他问审批,检索捞回来的是讲标准那一段。
模型没撒谎。它手上就只有半张纸。
先算一笔账:换模型换掉的是什么
三次换模型,加起来两个多小时。
这段时间里真正有效的事只有一件:把捞回来的原文打印出来看一眼。看一眼就明白,那一段开头是「住宿费标准如下」,结尾停在「特殊情况需报部门负责人」——审批的正文在下一段,压根没被送到模型面前。
我后来跟人讲这件事,只用一句话概括:切片是知识库的颗粒度,模型只是在这个颗粒度上做匹配。颗粒度错了,再强的模型也是在错的候选里挑选,挑得再准也救不回来。
换句话说,换模型换的是挑选的手,没换的是那些已经被切碎的东西。手再好,桌上就那几片纸,也拼不出完整条款。
这句话值得再说一遍,因为它解释了为什么很多人换了五六个模型,问题一次没变。
分四步改:先切对,再捞全
第一步,分段长度。600 提到 1000,上限不超过 2000。判断标准只有一条:一段要装得下一个完整条款,包括它的适用条件和例外。
第二步,切片方式。默认的智能切分换成按标题切——条款型文件的一级标题就是条款边界,切出来每段自带小标题,模型看到段头就知道自己在读哪一条,不会把标准和审批混成一团。
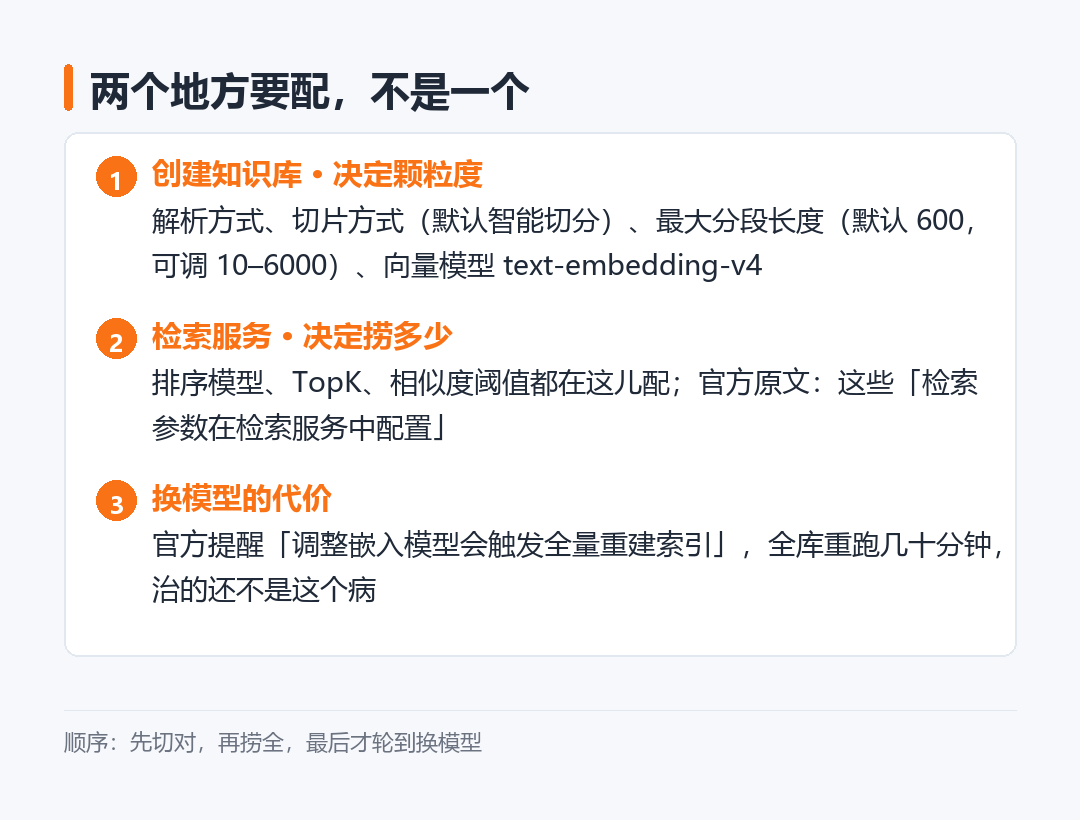
第三步,TopK。这一项他找了十分钟才找到,因为它根本不在创建页面里,而在检索服务那一层,入口名字还不叫「检索」,叫「检索服务」——差一个字,很多人就以为这里没有。
不知道和答不对,差在哪
这两件事,处理方式完全相反。
「不知道」是没捞到。百炼文档写得很直白:排序模型、TopK、相似度阈值这些「检索参数在检索服务中配置」。创建知识库那一步只管解析、切片、向量化,检索参数是另一个地方的事。九成人建完库就走,从来没打开过那第二处。
「答不对」是捞到了但读错。答案就在上下文里,模型理解偏了,那是提示词和指令的事。
分不清这两者,就会一直在错的层里使劲:明明是没捞到,却反复优化提示词,把提示词改到第三十版还是那几句车轱辘话;明明是读偏了,却一遍遍重建索引,看着进度条跑完再跑一遍,把一下午耗在一个跟答案无关的按钮上。
TopK 决定最多捞几段回来,默认值偏保守,只有最像的两三段能进模型视野;阈值偏高的时候,用户口语和文件用词差一层——文件写「住宿费标准」,人问「酒店能报多少」——相似度掉下去,条款直接被门槛挡在外面。
顺带两个坑
第四个参数是相似度阈值,往下松一档。松完重建,等索引跑完。这中间他问了一句:换更强的向量模型是不是更好?
我没让他换。默认的 text-embedding-v4 够用,而且文档写了「调整嵌入模型会触发全量重建索引」,换一次全库重跑几十分钟,治的还不是这个病。
第二个坑是上传。一次最多 50 个文件、单个不超过 150MB,八十多份材料要分两批;扫描件别用默认的电子文档解析,选文档智能解析,否则切出来全是乱码,后面怎么调都白搭。
可以直接抄的一段话
不想记参数的话,把下面这段原样发给负责搭助手的人,别自己转述,转述一次就丢一半细节:
「知识库按标题切,单段 800 到 1200 字,让一段装得下一个完整条款;切完抽 20 条真实提问跑一遍,看该出现的条款有没有被捞回来;召回不全就去检索服务里把 TopK 加到 5 到 8、阈值松一档;换模型放最后,换之前先确认颗粒度已经对了。」
16:10 复测,和三点复盘
再问「出差住宿超标怎么审批」,这次答的是原文:超标多少以内由部门负责人审批,超过多少报分管领导,附一张审批单。条款编号对得上,他翻文件核了一遍。
答得准不是重点。重点是那句「我不知道」消失了——原来模型不是不知道,是没拿到。
后来我们又抽二十条真实提问跑了一遍:十四条直接命中原文,五条答得笼统但方向对,一条仍然偏。那条偏的,问题出在原文件里写了两套口径,属于文件本身的坑,不是检索的锅。
复盘三句话。答偏先看颗粒度,别先换模型。切片和检索是两个地方,建库只做了前一半。判断切得好不好,不用看参数,抽十条真实提问,看该出现的原文有没有被捞回来。
为什么抽十条就够?因为这十条里只要有两条该出现没出现,说明是切片问题;十条都出现了却答得偏,才轮到提示词和模型。
那天他问我要不要把这套配置写成一页纸贴工位上。我说可以,但顺序别记反:先切对,再捞全,最后才是换模型。
下次你的助手答偏,你会先翻它的切片设置,还是先打开模型列表?