周五下午四点,阿哲要发一张活动海报。
他在生图工具里敲下「秋季读书会,10 月 30 日 19:00,三楼活动室」,后面接了一段画面描述:木质长桌、暖光、几本摊开的书。他想一步出图,把排版的活儿一起省掉。
他要的不是一张艺术品,是一张能按时发出去的图。
出来的东西不对。
第一版「读书会」的「读」少了一点,第二版日期成了「10 月 3O 日」、数字 0 和字母 O 混在一起,第三版干脆多出一行谁也不认识的字,他盯着看了半天,也没认出那到底是哪几个字。
试到第四版,他终于选中一张,可要把图里的「19:00」改成「19:30」,只能整张重出——重出之后,构图又变了。
他想过只补那个位置,把时间盖住。可底图是一整张像素,没有「只改这里」的选项。改,就得整张来。
阿哲走的是 A 路,他把文案全写进提示词,指望模型连图带字一次出完,从周五下午四点一直试到快六点,四版图里没有一版的字是全对的。
那 B 路呢?
同一张海报,两条路各走一遍
同一张海报,两种走法。
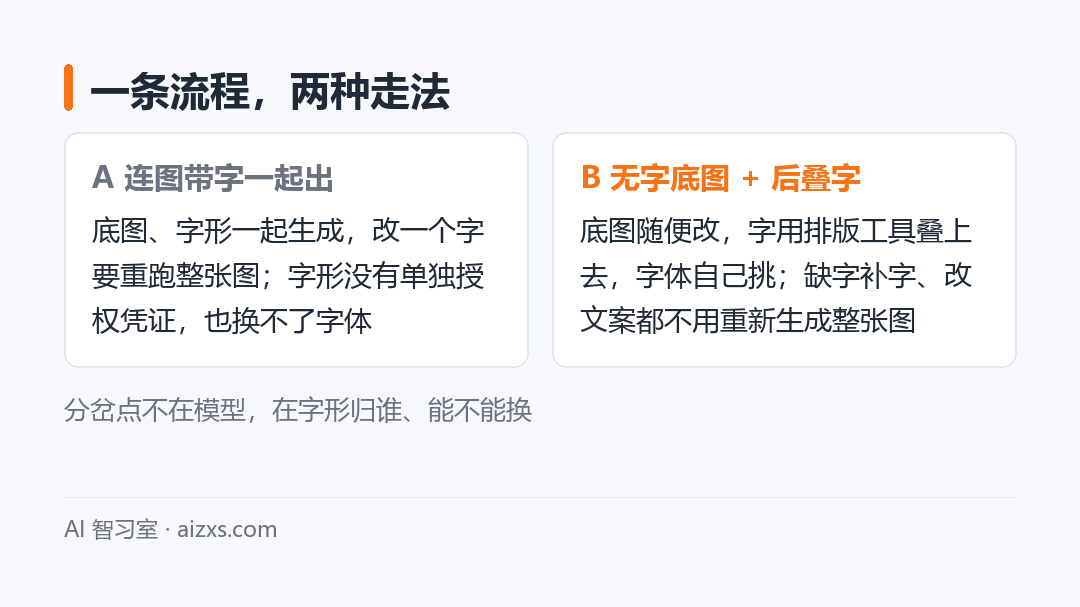
A 路:提示词里把文案写全,让模型连图带字一起出。
B 路:先出无字底图,字用排版工具叠上去。
我们用同一张「下周要发的活动海报」,两条路各走一遍,看四件事:出几次图、错字怎么发生、改一个字要多久、授权凭证在谁手上。
差在哪:一次出图与四版重出
字错一次,代价是什么?
A 路的出图次数不由你定,因为字错一次就得重出一张,而阿哲出的这四版每一版都是全新画面——模型每次都重新理解一遍「木质长桌、暖光、几本书」,它没有「沿用上一张」这个概念。
B 路的底图出一次就够,因为字是后面叠上去的,错字跟出图这件事本身没有关系,底图可以一直用下去。
这里有个容易忽略的差别:A 路每出一次图都是一次重新抽签,你并不知道下一次是字碰巧对了,还是构图变得更差。
B 路只抽一次,抽完就定型。后面所有的调整,都在一张定下来的画面上做加减。
不用重来。
一次错字,A 路付的是一张图的代价,B 路付的是一行字的时间。
为什么字总是画不准
它真的没听清吗?
阿里云百炼那份《文生图 Prompt 指南》把写提示词拆得很明确。更新日期是 2026 年 10 月 10 日,适用范围写明含万相文生图 V2 和 V1。它给的基础公式是「主体 + 场景 + 风格」,进阶公式再往上叠镜头语言、氛围词、细节修饰;配套的提示词词典,列的是景别、视角、镜头拍摄类型、风格、光线这五个维度。
六个要素,五个维度,从头到尾没有一项是「图里要出现什么字」。
所以你在提示词里写「主标题:周六见」,模型接到的不是「排一行字」这个指令,而是「画面里好像有字」这个视觉印象,它照着有字的样子去画像素,不是照着字义去排版。
字写错了,不是它没听清,而是这件事根本不在它的任务描述里——所以不管你重出多少次,都只是在赌下一次,赌它恰好把那一笔放在了对的位置上。
它拿到的是一整张画布和一段文字描述,然后一次性决定每个像素该是什么颜色,而不是先排好一行字、再决定每个字放在哪、最后才渲染成形,这两条路径的差别,就是「几乎对」和「完全对」的差别。
中文的麻烦还在笔画密。「读书会」三个字,横竖撇捺加起来二十多笔,每一笔都要落在对的位置才认得出是哪个字,而它拿到的判断是整张图「像不像」,不是逐笔去核「这一横有没有压在对的高度上」。
这也是「少一点」这种错特别常见的原因:结构还在,笔画的落点偏了一点,眼睛一看就觉得不对,可你又说不出哪里不对。
补充一条旁证。《万相文生图 V2 API 参考》通篇没有图内文字的能力说明,痕迹只剩下反向提示词示例里的那一句「构图混乱。文字模糊,扭曲。」
另一家的官方口径,也只说到「某个程度」。字节 Seed 官方博客在介绍 Seedream 4.0 时,原话说它「在文字处理上突破了以往生成模型的瓶颈」,能正确渲染出清晰的文字,也能处理公式、表格、化学结构、统计图这些复杂排版——但后半句挂着一个限定词,说的是「在某种程度上」,不是保证。
「以往生成模型的瓶颈」这半句更值得留意。那是官方自己在承认,这是一个旧问题,不是哪一家的偶发失误。
换句话说,两家给的答案其实是同一件事的两面:一家干脆不承诺,一家承诺到「某种程度上」为止,而对你真正有用的那几条信息——图里那行字到底是什么字体、能不能换成另一款、出了事由谁来担——两家的文档里都没有写。
改一个字的成本
改一个数字,要花多久?
先说结论:一行字的改动,在 A 路上要按「张」重算。
A 路等于重做一张:你得改提示词、重出、再从新的一堆里挑,而新图里桌子可能换了方向、光可能从左边挪到了右边,字还没改对,画面先跑了。
更麻烦的是,改完之后你没法确认别的字有没有跟着变。整张重出,等于所有字重新赌一遍——你为了把「19:00」改成「19:30」,可能把原本对的「三楼活动室」弄错。
B 路是双击文字层,删一个字符,敲两个,回车。底图不动,别的字也不动。
一句文案的修改成本,A 路按「张」算,B 路按「秒」算。
授权这栏的坑
这栏比前几栏难。方正字库《商业授权》页把「发布使用」的字体分成三类。
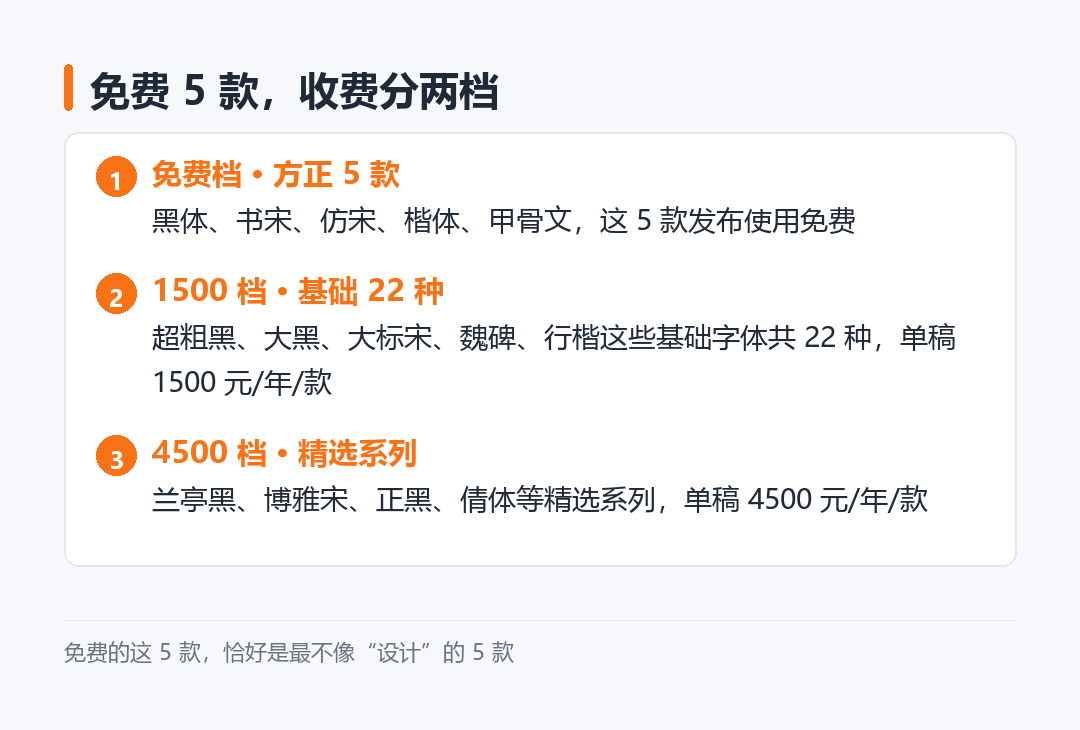
第一类是免费字体,五种:方正黑体、方正书宋、方正仿宋、方正楷体、方正甲骨文。官方原话是「针对发布使用这种使用方式免费」。
第二类是基础字体,二十二种。超粗黑、宋黑、大黑、中等线、粗圆、报宋、大标宋、琥珀、隶变、魏碑、行楷、综艺体这些名字都属于这一档。
第三类是精选字体,官方定义为「除免费字体、基础字体类以外的其它全部方正字体」,并举了例子:方正兰亭黑系列、博雅宋系列、正黑系列、倩体系列。
三档是按「哪些字体」分的,不是按你怎么用分的。同一张海报,字换成兰亭黑,价格就从 1500 跳到 4500。
价格表里 B 类叫「设计案发布」,单位是万元每年每款字体。海报这一行(易拉宝、背景板、促销单张等)写着两档:基础字体 0.15,精选字体 0.45。
换成钱,就是 1500 元和 4500 元。同类还有平面广告、户外广告、影视广告、网络广告、新媒体应用,都是这个价。官网商城另按「1500 元一张一款字体起」标海报类。
细则也得看原文:「大于等于三个设计稿,则按照单一设计稿授权价格 3 倍计算」「单一设计稿超过 2 款字体,按照 1 款字体单一设计稿授权价格 2 倍计算」。
一张海报里放两款字体,单价翻倍;一次交三个设计稿,再乘三。稿子改得越勤的团队,这栏的数越往上走。
那 A 路的授权凭证在哪?
字是从模型那张图里长出来的,你手上既没有字形来源,也没有一份能用名字对上的授权关系,想补也补不了,因为模型不会告诉你它画的是哪一款字体。
图里那几个字,到底是什么字体?
你答不上来。
你把这张图交给法务,他能做的只有看图猜字体:横的粗细、竖的收笔、标点的弧度,全靠眼睛比对,猜完了还得去字库官网一款一款翻着确认,翻到了也不能证明模型画的就是那一款,因为模型从头到尾没说过它参照的是谁。
方正同一页还写着三句:「计算机字库是典型的拥有著作权的作品」「任何使用方式都必须事先获得著作权人得授权」「方正公司仅针对发布内容的最终所有者提供授权」。
要是把图交给法务,他问的第一句就是:这几个字从哪来的?你只能答一句「图里带的」。这四个字,撑不起一份授权。
B 路这栏是干净的:字体是你自己从字库里挑的,名字写在文件里,授权关系对得上号,凭证在你手上。
挑那五款免费字体,成本为零,可它们恰好也是离「设计感」较远的那五款,真要海报的气质,兰亭黑、博雅宋、倩体全在 4500 那一档,这不是巧合,是字库的定价逻辑——越像「被设计过的字」,数字越贵。
小结:什么时候可以直接让模型写
有些场合 A 路没问题:图里只有三五个大字、字的位置不在关键处、发出去不挂商业用途、错了能撤下来重发,那让它一步出图是省事的。
活动海报不在此列:日期、时间、地点,一个字都不能错,而改稿又是常态。
如果你担心的是「不敢用」,开源字体那条路能解。SIL Open Font License 1.1 的原文写着:这份协议允许被授权的字体被自由地使用、研究、修改和再分发,唯一的限制是不能把这些字体本身单独拿去卖。
最有用的其实是另一句:这份协议的约束,不适用于用这些字体做出来的任何文档。
换句话说,用这些字体做出来的海报,是你自己的东西,不会被这份协议「传染」。
这题不是选模型,是选工序。
真正决定这栏签不签得下来的,不是你选了什么工具、花了多少钱、出了几版图,而是那几个字在物理上属于谁——它如果是你从一个有名字的字库里调出来、放在一个有图层的地方,那它就归你;它如果是模型在画一张画的时候顺手带出来的,那它就谁也不归。
分人群说结论。
一周出两三张图、字少、发错了能撤,让模型连图带字一起出够用了,只是别给字定太高的准头要求,也别指望每一次都抽中。
一周出十几张、字多、改稿频繁、要留授权凭证,出无字底图,字自己叠。多花一步排版,省下的是重出和签字的来回。
两条路的分界,不在你的审美,在你对「错一个字」的容忍度。
想找工具,即梦AI 和 通义万相 走的是连图带字那条路,出无字底图也行;稿定AI 的排版层,是叠字那条路的活儿。
你手上那张海报,日期和时间改过几次?