本地大模型

2

Qwen3+Phi-4 消费显卡实测:32B 模型在 4090/5090/M4 Pro 跑出 78 tok/s

6 月底到 7 月初,本地大模型生态出现了三个肉眼可见的拐点:一是 Qwen 团队连续放出 Qwen3-32B 和 Qwen3-Next 80B 的本地友好权重,32B 模型在 24GB 显存上第一次实现全精度运行;二是微软 Phi-4 14B 用 14B 的小钢炮体量,跑分压过了一票 70B 模型;三是 arxiv 在 7 月初挂出的 Wiola 架构论文,把”小模型高效推理&#82…

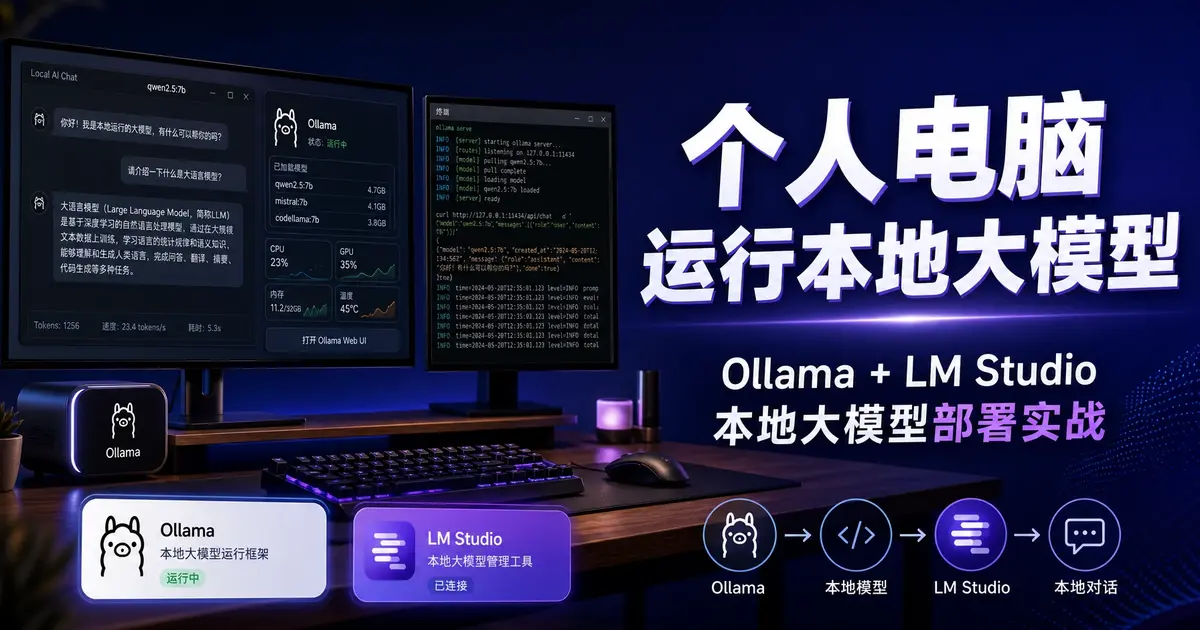
【AI 学习拼图系列】Ollama + LM Studio 本地大模型部署实战:消费级显卡跑通 70B 开源模型

2026 年是”本地大模型”元年。 云端 API 价格战打了两年,DeepSeek 把百万 Token 干到 1 元,Claude Opus 4.8 也只敢收 15 元/百万 Token——但调用 1 次就要联网,1 小时写 50 个 Prompt 就开始心疼钱包;公司内部知识上传给第三方 API,法务和安全部门能把你拉去喝茶 3 次;移动办公、差旅、客户现场演示,没网就抓…