把 Claude Code 接任意模型:42 家厂商随便切
Claude Code 好用,但它有个隐含前提:你得用 Anthropic 的模型。 想换成 DeepSeek 省钱、想切到本地 Ollama 跑私有模型、或者想在主服务挂掉时自动切到备用——这些都得自己想办法。 8 月 27 日出现在 GitHub 上的开源项目 my-free-code,就是来解决这件事的。 它是一个多提供商 AI 网关,架在 Claude Code(以及其他编程智能体)和模型…
共 31 篇
Claude Code 好用,但它有个隐含前提:你得用 Anthropic 的模型。 想换成 DeepSeek 省钱、想切到本地 Ollama 跑私有模型、或者想在主服务挂掉时自动切到备用——这些都得自己想办法。 8 月 27 日出现在 GitHub 上的开源项目 my-free-code,就是来解决这件事的。 它是一个多提供商 AI 网关,架在 Claude Code(以及其他编程智能体)和模型…
你有没有遇到过这种情况:想让 AI 帮你读完一份几十页的产品手册再回答问题,结果它读到后面忘了前面。 想让它分析一整年的销售明细,它却只能一小段一小段地喂进去,最后给出的结论前后打架。 这不是模型笨,是上下文不够用。 9 月 1 日,科大讯飞全资子公司词元星火开源了星火 X2.5-4B 和星火 X2.5-1.7B 两款端侧模型。 把这个问题往前推了一大步——它们是端侧模型中首个原生支持最长 100…
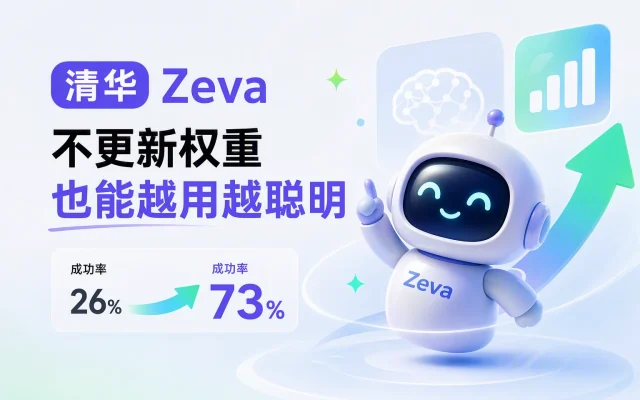
机器人一直有个老大难问题:换个环境就「失灵」。在实验室里学会的操作,换个场地、换个工具,往往要重新采集数据、重新训练,9 月 1 日,清华 AIR(智能产业研究院)联手域变换发布了一个名为 Zeva 的模型,给出了一条完全不同的路:模型权重不用更新。 机器人也能从自己的交互经验里持续学习,越用越聪明。 Zeva 是什么:首个实现 ICCL 的具身世界模型 Zeva 的定位是首个实现 In-Cont…
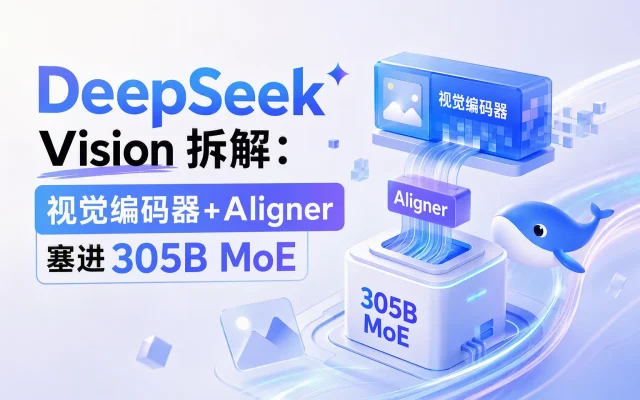
8 月 31 日 DeepSeek 开源了 V4 家族首个多模态模型 DeepSeek-V4-Flash-Vision-Exp,新闻已经刷屏。 但大部分报道只讲了「305B 参数、逼近 Opus 4.8」这些结论,很少有人拆开讲:这双「眼睛」在架构上到底怎么装进语言模型的? 为什么它不给人类看图、专给 Agent 用?想本地跑起来,到底要什么配置?这篇从技术角度完整拆一遍。 架构:视觉编码器 + …
过去我们聊多模态模型,第一反应都是「AI 看图说话」——你发一张照片,它给你描述一段话,但 8 月 31 日 DeepSeek 在 Hugging Face 开源的 V4 家族首款多模态模型 DeepSeek-V4-Flash-Vision-Exp。 方向完全不一样:这双「眼睛」不是给人看图,而是专供 AI Agent 看屏幕干活。 305B 参数的「眼睛」,MIT 许可直接免费商用 先说硬指标。…
8 月 31 日,MiniMax 宣布 H3 Max 768P、H3 Max 480P 正式接入 MiniMax 开放平台和 MiniMax Design,这款由 fal 基于 MiniMax H3 开源权重做后训练和推理优化的模型。 把一段 5 秒、768p 的完整音视频生成时间压到了不到 3 秒——生成速度第一次跨过了播放速度,与此同时,海外开发者已经用它搭出了 Twitch 实时直播和 24…
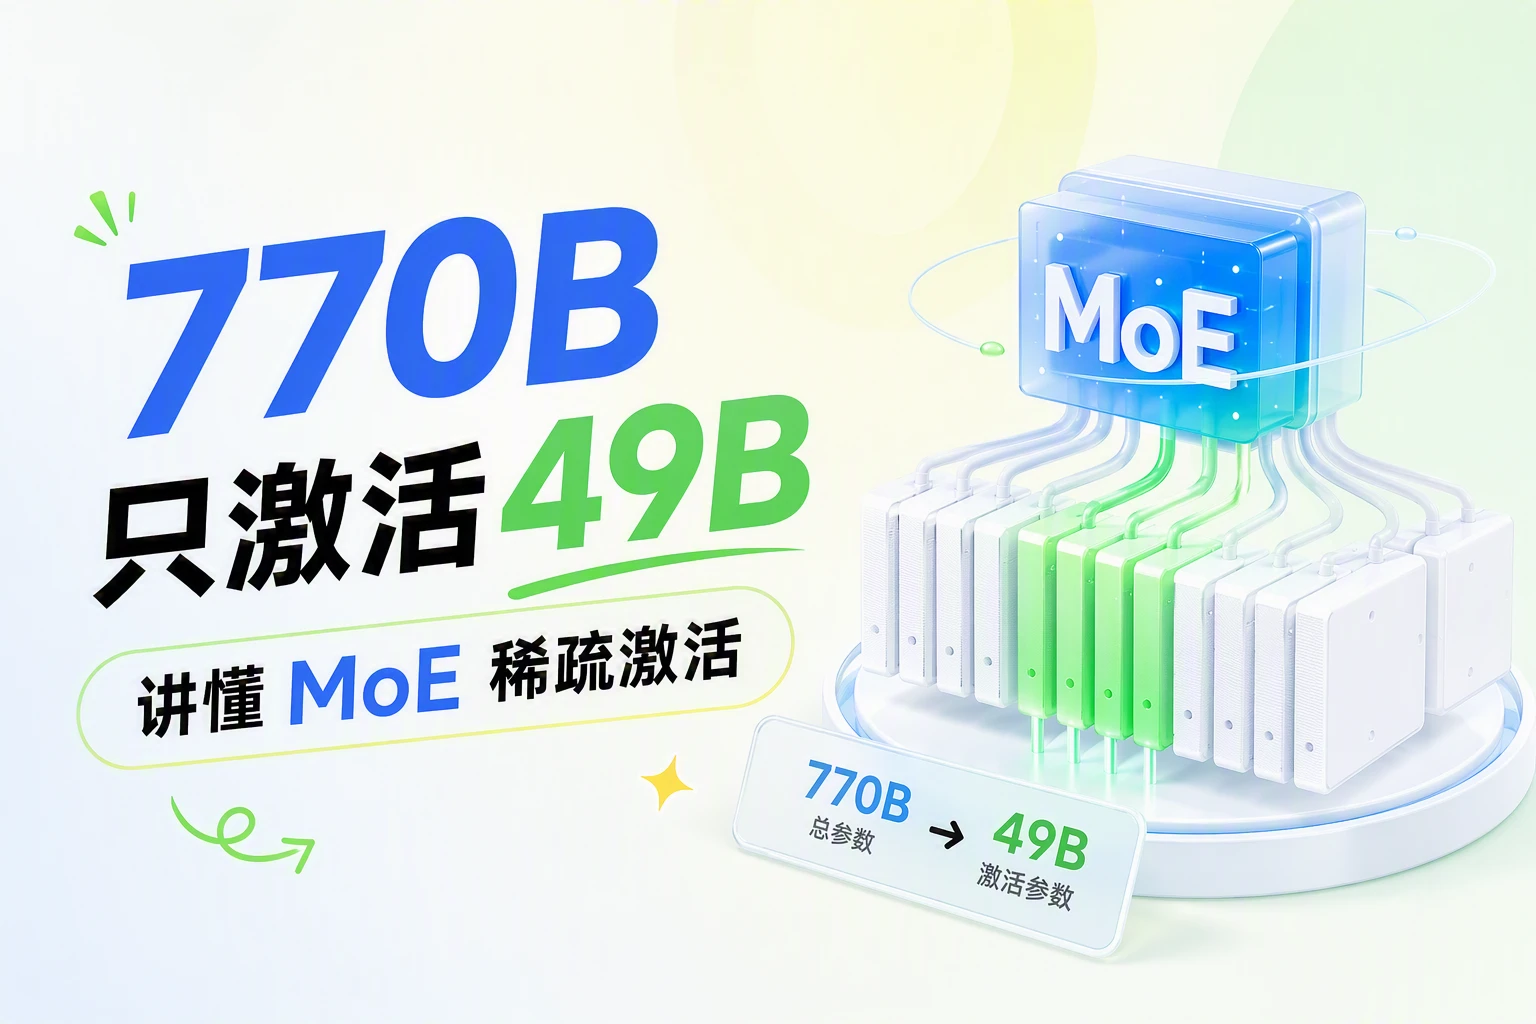
先抛一个反直觉的事实:腾讯混元 8 月 28 日发布的 Hy4 preview,总参数 770B,每次推理只激活 49B,上下文 1M。七百七十亿参数只激活一小半,这账怎么省的? API 输入定价 6 元每百万 token。 大,通常意味着贵。但这次是又大又便宜。中间的矛盾,靠一个叫 MoE 的架构给抹平了。 这篇不讲公式,只把三件事讲明白:MoE 稀疏激活到底省了什么、1M 上下文意味着什么、以…
先问一个问题:你觉得现在用一次「旗舰级」大模型,要花多少钱? 很多人的印象还停留在「能力越强越贵」,但 8 月 28 日腾讯混元发布的 Hy4 preview,把这个印象按在地上摩擦了一遍——770B 总参数、1M 上下文的旗舰模型,开源免费拿走,API 输入只要 6 元每百万 token,还有产品端限时 2 周免费。旗舰模型白菜价,你会现在就换过去吗? 这不是一个小版本更新,而是国产大模型第一次…
大模型训练的「效率天花板」可能要被打破了。 8 月下旬,中国人民大学高瓴人工智能学院李崇轩、文继荣团队联合蚂蚁集团。 发布了一项重量级研究:首次系统刻画了混合专家(MoE)扩散语言模型的扩展定律,并据此从头训练出新一代扩散语言模型 LLaDA MoE v2——只用了 Qwen3 同规模约 65% 的预训练词元,就在多项基准上逼近甚至超越 Qwen3 的水平。 这是扩散语言模型路线的一个重要里程碑。…
国产大模型的发布节奏越来越快了。 8 月 14 日这次发布,编程拿到开源榜首,为什么值得在意?因为代码是检验模型能不能真干活的直接标准,榜单之外还得看这一点。 8 月 14 日,智谱 AI 发布新一代基座模型 GLM-5.3,两个卖点迅速引发讨论:编程能力做到开源第一,同时涌现出网络安全能力,消息一出,”国产模型又卷出新高度”的话题在开发者圈子里迅速升温。 GLM-5.3 …
2026年6月8日,港股”AGI第一股”云知声扔出一颗深水炸弹:新一代通用大语言模型U2正式发布,这不是又一个万亿参数的”军备竞赛选手”,而是一个反过来质疑”参数越大越好”这条底层逻辑的挑战者,2660亿MoE总参数、100+步复杂工作流自主拆解、GPQA Diamond 87.9分超过DeepSeek-V4-Flash(Hi…
Qwen3.7-Max跻身全球前五,国产大模型进入”执行时代” 2026年5月,AI行业迎来极为密集的升级周期,短短一个月内,GPT-5.5、DeepSeek V4、Qwen3.7-Max、Kimi K2.6等9款重量级模型集中发布,这场被称为”大模型集中爆发月”的浪潮中,国产大模型的表现格外亮眼——阿里Qwen3.7-Max以56.6分跻身全球前五…
程序员最烦什么?重复性代码写到手抽筋。 明明是重复的业务逻辑,却要一行一行敲;明明是常见的功能模块,却要从零开始写。GitHub Copilot很好,但它每月10美元、价格劝退;国产有没有免费又好用的替代品? FittenCode来了。 这是2026年爆火的国产AI编程助手,支持VS Code和IntelliJ IDEA插件,可以帮你智能补全代码、生成函数、解释代码、Debug。据实测,Fitte…
2026年3月30日,AI圈迎来重磅消息。 阿里巴巴正式发布千问系列新一代全模态大模型——Qwen3.5-Omni。 这不是一次普通的版本更新。在音视频理解、识别、交互等215项任务中,Qwen3.5-Omni全部取得SOTA(State of the Art,最佳性能),直接超越了Google的Gemini-3.1 Pro。 这意味着什么?阿里的大模型能力,正式站上了全球第一梯队。 今天,我就给…
你还在同时开着浏览器和AI聊天窗口来回切换吗? 2026年,有一个工具把AI直接装进了浏览器——夸克AI。 夸克是阿里巴巴推出的智能浏览器,2026年全面接入了AI能力。不只是搜索,而是把AI助手深度集成到了浏览器里:网页分析、文档处理、搜索增强——你在浏览器里做的所有事情,AI都能帮你。 今天,我就给大家做一个深度测评,看看夸克AI到底有多实用。 一、产品简介:夸克AI是什么 夸克AI是阿里巴巴…
2026年2月6日凌晨,AI圈发生了一件大事。 就在OpenAI发布GPT-5.3-Codex、Anthropic推出Claude Opus 4.6的同一天,字节跳动Seed团队悄然发布了Seedream 5.0——一款被业内称为”图像革命”的AI绘图模型。 而承载这个模型的,正是字节跳动的AI创作平台——即梦AI(jimeng.jianying.com)。 即梦AI在20…
2026年,AI办公赛道迎来最强选手。 钉钉有”悟空”,企业微信有AI助手,而字节跳动的飞书——带来了飞书aily。 这不是一个简单的AI功能叠加,而是一套完整的智能办公解决方案。从文档协作到会议管理,从业务提效到组织管理,飞书AI想把AI能力渗透到企业办公的每一个环节。 飞书aily是飞书在2025-2026年AI浪潮中推出的智能体产品。和其他AI办公工具”给…
2026年,AI视频剪辑赛道神仙打架,Adobe Premiere Pro有Firefly加持,万兴喵影有全链路AI,快影接入了DeepSeek R1——但最让我惊喜的,是剪映的全面升级,2026年2月,字节跳动推出Seedance 2.0新一代视频生成大模型,同日剪映宣布完成深度集成,用户只需将剪映App升级至18.8.0版本,即可在首页直接启用AI视频生成功能。 这意味着什么?剪映用户现在可以…
2026年4月1日,阿里巴巴通义实验室正式发布图像生成与编辑统一模型——Wan2.7-Image。 这是国内首个将图像生成与编辑能力深度融合的统一模型,标志着AI图像创作从”千篇一律”正式进入”千人千面”的新时代。 你是否有这样的困扰:用AI生成的图片,人物总是”网红脸”?颜色总是”失控”?想要精准控制…
2026年4月1日,阿里正式发布万相2.7图像大模型(Wan2.7-Image)。 这不是一次普通的版本更新,而是阿里在AI图像生成领域投下的一颗重磅炸弹。 如果说之前的AI绘图是”开盲盒”——每次生成都是随机抽卡。 那么Wan2.7-Image则把绘图变成了”精准手术”——你想让眼睛是丹凤眼就是丹凤眼,想让肤色是小麦色就是小麦色。 每一个细节都在你…
2026年3月,SEMICON CHINA 2026在上海新国际博览中心盛大开幕。作为全球最大的半导体产业盛会,本次展会汇聚了来自世界各地的半导体设备、材料、设计、制造等全产业链的企业和专家。 在本次展会上,一个中国企业的名字被反复提及——中微公司(AMEC)。 中微公司不仅发布了四款重磅新品,还斩获了”杰出半导体设备奖”,成为本次展会最受瞩目的中国半导体设备企业。 一、中…
2026年3月,一个重磅消息在半导体圈炸开了锅:平头哥镇岳510芯片累计出货量突破50万片。 这意味着什么?意味着国产SSD主控芯片首次实现规模化商用,打破了一直以来被国外巨头垄断的局面。 一、镇岳510是什么? 平头哥是阿里巴巴旗下的半导体公司,而镇岳510是其推出的高性能SSD主控芯片。 核心参数: 制程工艺:12nm FinFET 接口协议:PCIe Gen4 x4 / NVMe 1.4 最…
🔹 导语 长文本这条路,你走过吗? 2026 年,国内大模型市场竞争进入白热化阶段。 MiniMax 的海螺 AI,2025 年发布后迅速走红,主打长文本处理和多模态能力。 有人说它是”国产 GPT-4 最强黑马”,也有人说它”长文本强,其他一般”。 海螺 AI 的 256K 上下文真的有那么强吗?多模态能力如何?API 开放程度怎样? 为了搞清楚这…
🔹 导语 语音强、其他一般,这个评价你认不认? 2026 年,国内大模型市场竞争进入白热化阶段。 科大讯飞的讯飞星火,依托 20 多年语音技术积累,在语音识别和会议记录场景独树一帜。 有人说它是”会议记录神器”,也有人说它”除了语音强,其他一般”。 讯飞星火到底有没有那么强?它的语音转文字真的有那么准吗?教育辅导能力如何? 为了搞清楚这些问题,我花了…
精选工具、实操步骤与副业思路,免费送到邮箱。不推销、不打扰,随时退订。
每周一封,随时退订。