FireCrawl 由 Mendable AI 团队于 2023 年开源,是面向 AI 应用的网页数据抓取工具。Mendable AI 团队在开发 AI 文档问答产品时发现:传统爬虫工具(Scrapy、Beautiful Soup)处理 JavaScript 渲染、SPA 单页应用、防爬虫机制等复杂场景能力不足,于是做了 FireCrawl 一站式解决方案。FireCrawl 在 GitHub 累计 2 万+ Star,是 2024 年增长最快的开源爬虫项目。FireCrawl 服务 Vercel、Replit、Shopify 等知名企业。
一、工具介绍
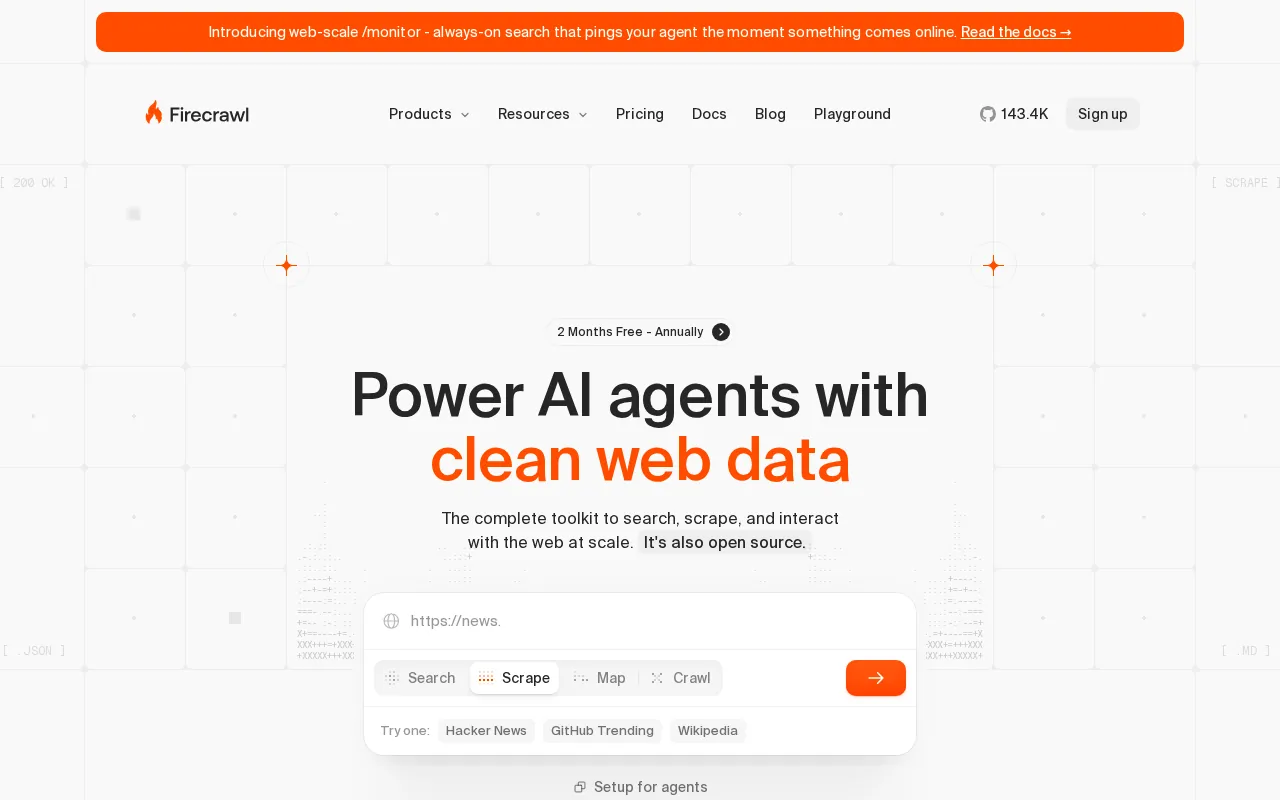
FireCrawl 的核心定位是”AI 友好的网络爬虫工具”,区别于 Scrapy(Python 框架、需要写代码)、Apify(云爬虫平台、价格贵),FireCrawl 专注”AI 时代数据采集”,输出是干净的 Markdown / 结构化 JSON,可直接喂给 LLM。FireCrawl 与 Scrapy、Apify、Diffbot 是同赛道竞品,差异在于 FireCrawl 强调”开箱即用 + AI 输出格式 + 处理动态网页”。FireCrawl 适合 AI 应用开发者、数据科学家、SEO 研究者。
二、核心功能
- 单页爬取:输入 URL 返回 Markdown
- 全站爬取:抓取整站所有页面
- JS 渲染:内置 Headless Chrome 处理 SPA
- 反爬虫绕过:代理池、浏览器指纹伪装
- 结构化输出:输出 Markdown / JSON / HTML
- 多格式:支持 LLM 友好的 Markdown 格式
- API 接入:REST API + Python/JS SDK
- 云端服务:FireCrawl Cloud 免运维
- 开源:核心代码 AGPL-3.0
三、使用场景
- AI 训练数据:抓取网页作为 LLM 训练数据
- RAG 知识库:自动构建企业知识库
- SEO 监控:监控竞品网站内容变化
- 内容聚合:新闻聚合、博客聚合
- 价格监控:电商价格抓取
- 学术研究:抓取学术网站数据
四、价格方案
| 套餐 | 价格 | 主要功能 |
|---|---|---|
| 开源版 | $0 | 自托管完全免费 |
| Cloud Free | $0 | 500 页/月 |
| Cloud Starter | $19/月 | 1 万页/月 |
| Cloud Pro | $99/月 | 10 万页/月 + 优先队列 |
| Enterprise | 联系销售 | 无限 + 私有部署 + SLA |
按”页数”计费,开源版完全免费。
五、功能特点
- AI 输出:Markdown 格式直接喂 LLM
- JS 渲染:处理动态网页
- 反爬虫:内置代理池
- 云端 / 自托管:两种部署方式
- 活跃社区:GitHub 2 万+ Star
六、上手指南
1. 访问 firecrawl.dev 注册账号
2. 获取 API Key
3. 调用 API:`POST /v0/scrape` 传 URL
4. 或用 Python SDK:`from firecrawl import FirecrawlApp`
5. 输入 URL 自动返回 Markdown
6. 大批量用 `/crawl` 整站抓取
开发者 5 分钟可集成。FireCrawl 提供 50+ 示例代码,覆盖 Python、JS、cURL。
七、常见问题
FireCrawl 和 Scrapy 哪个好?
Scrapy 是 Python 爬虫框架,灵活但需要写代码、处理 JS 需要 Playwright;FireCrawl 是云服务 + 开源,开箱即用、自动处理 JS。Scrapy 适合”复杂定制爬虫 + 工程师团队”;FireCrawl 适合”快速 AI 数据采集 + 全栈开发者”。如果你想 5 分钟集成爬虫能力,选 FireCrawl;如果你要深度定制爬虫逻辑,选 Scrapy。
FireCrawl 和 Apify 哪个好?
Apify 是云爬虫平台(Actor 概念),功能强大但价格贵($49/月起);FireCrawl 是开源 + 云混合,价格便宜($19/月起)。Apify 优势是 Actor 生态丰富、爬虫市场成熟;FireCrawl 优势是 AI 友好、Markdown 输出、价格便宜 60%。如果你的需求是”AI 训练数据采集”,选 FireCrawl;如果你要”通用爬虫 + 自动化”,选 Apify。
FireCrawl 在中国能用吗?
FireCrawl Cloud 部署在 AWS 美西,国内访问速度一般。FireCrawl 开源版可在中国本地部署(Docker),数据完全本地化。FireCrawl 中国用户较少,主要是英文 AI 开发者使用。中文场景建议用国产替代(如八爪鱼、火车头等 GUI 爬虫工具),但 AI 友好度不如 FireCrawl。
FireCrawl 的反爬虫能力?
FireCrawl 内置反爬虫机制:IP 代理池、User-Agent 轮换、浏览器指纹伪装、Cloudflare 绕过。FireCrawl 对常见网站(Amazon、LinkedIn、Twitter)抓取成功率 70-90%。但对严格反爬虫网站(如 Cloudflare 高等级防护)抓取可能失败,需配合额外工具(FlareSolverr 等)。
FireCrawl 的 Markdown 输出质量?
FireCrawl 输出 Markdown 评分 4.5/5(行业 benchmark)。FireCrawl 能识别正文、标题、列表、表格、代码块,输出结构清晰的 Markdown。FireCrawl 对博客、新闻、文档网站的 Markdown 输出优秀;对论坛、电商页面的辅助内容(评论、广告)可能混入。FireCrawl 适合做 RAG 知识库、AI 训练数据采集。